GenAI-Bench
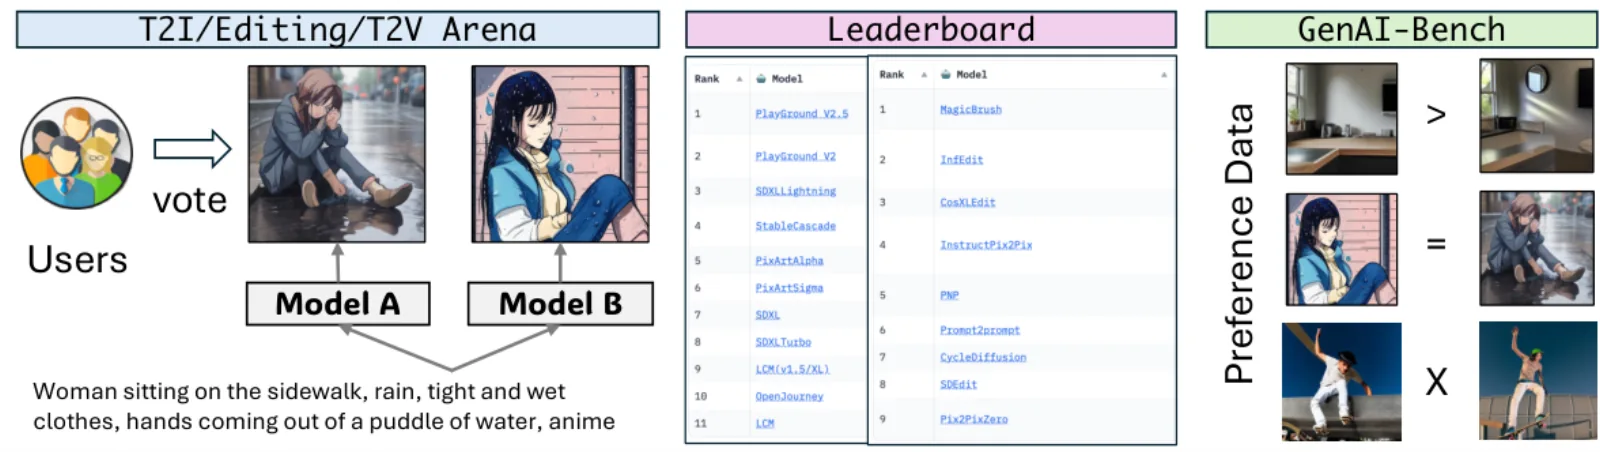
GenAI-Bench (TIGER-Lab, University of Waterloo; released with GenAI-Arena) measures whether an automatic judge matches human preference, not whether a generator looks pretty. Each record pairs two outputs for the same prompt with a human label. WorldFoundry scores pairwise accuracy overall and on three tasks:
- Image generation
- Image editing
- Video generation
genai_bench_average is the mean of task accuracies when every task-level pair is present.
Paper: GenAI-Bench. Code: TIGER-AI-Lab/GenAI-Bench. Dataset: TIGER-Lab/GenAI-Bench (CC-BY-4.0).
WorldFoundry normalizes official result rows. A row must expose task (image_generation / image_editing / video_generation), a human label (human_label / human_preference), and a judge prediction (prediction / judge_prediction). It does not synthesize preference labels.
Dimensions
- Image generationKindTask
Pairwise judge accuracy against human preference labels for image generation.
- Image editingKindTask
Pairwise judge accuracy for image-editing preferences.
- Video generationKindTask
Pairwise judge accuracy for video-generation preferences.
Data composition
- Size
TIGER-Lab GenAI-Bench / GenAI-Arena preference pairs: image generation, image editing, and video generation with human labels.
- Sources
TIGER-Lab/GenAI-Bench · github.com
- Modalities
image · video · text
- License
cc-by-4.0
- Notes
This scores judges against humans. WorldFoundry does not synthesize preference labels.
Metrics
Metric
- DirectionHigher is better
pairwise_accuracyGenAI-Bench pairwise accuracy against human preference labels across available tasks.
- DirectionHigher is better
image_generation_preference_accuracyGenAI-Bench image-generation preference accuracy against human labels.
- DirectionHigher is better
image_editing_preference_accuracyGenAI-Bench image-editing preference accuracy against human labels.
- DirectionHigher is better
video_preference_accuracyGenAI-Bench video-generation preference accuracy against human labels.
- DirectionHigher is better
genai_bench_averageMean of task preference accuracies when task-level labels and predictions are available.
PrimaryGenAI-Bench average
Leaderboard
Results from the paper (not a live board; not WorldFoundry-run scores). Judge alignment with human preference, not a generator quality board. Snapshot dated 2024-08-09 on the official dataset card. GenAI Arena: An Open Evaluation Platform for Generative Models (2024).
| Model | Pairwise accuracy average (test_v1) |
|---|---|
| GPT-4o | 49.2 |
| Gemini-1.5-Pro | 48.94 |
| LLaVA | 31.17 |
| Idefics2 | 28.67 |
| Random | 25.47 |
How to run
worldfoundry-eval zoo benchmark-run \
  --benchmark-id genai-bench \
  --mode official-validation \
  --official-results-path <official_results.jsonl> \
  --generated-artifact-dir <generated_videos> \
  --output-dir tmp/genai-bench/official-validation \
  --json
--preference-pairs-path supplies the pair inventory. Default import path: WORLDFOUNDRY_GENAI_BENCH_RESULTS_PATH. Shared assets: genai_bench_dataset_assets, t2v_metrics_source_assets.
In-tree pointer: worldfoundry/data/benchmarks/tasks/external/genai-bench.yaml.
Outputs include scorecard.json (primary genai_bench_average), benchmark_contract.json, and raw_metric_table.jsonl.