GenAI-Bench
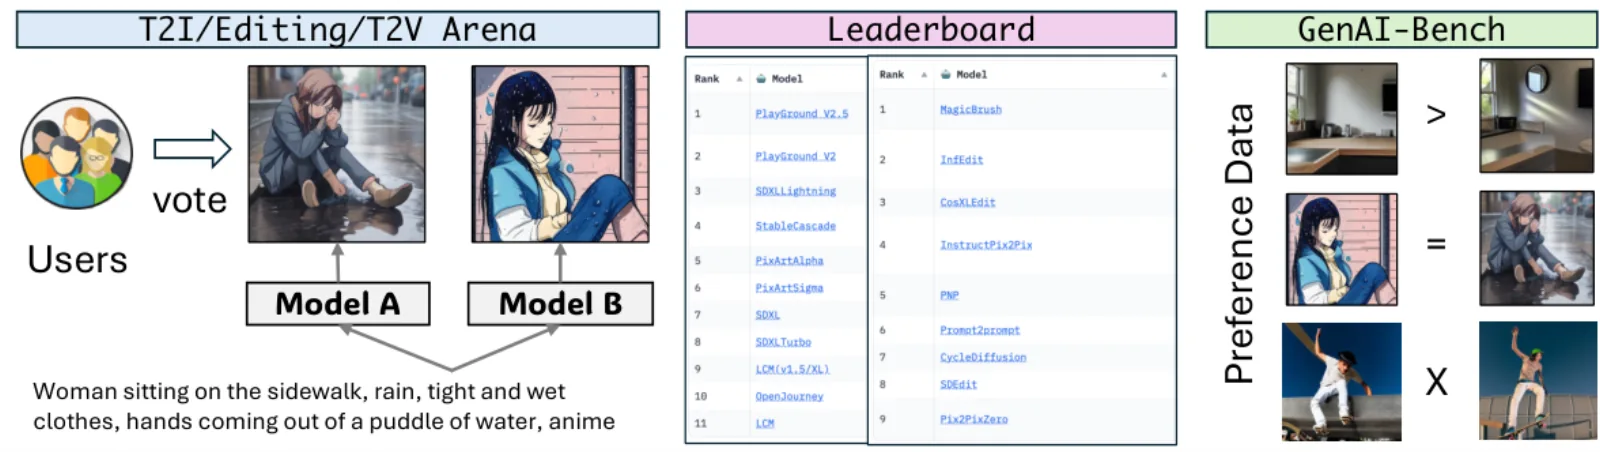
GenAI-Bench(滑铁卢大学 TIGER-Lab,随 GenAI-Arena 发布)测的是自动裁判是否对齐人工偏好,不是生成器好不好看。每条记录是同一 prompt 的一对输出加人工标签。WorldFoundry 打整体 成对准确率,并按三个任务拆开:
- 图像生成
- 图像编辑
- 视频生成
任务级成对齐备时,genai_bench_average 是各任务准确率的均值。
论文:GenAI-Bench。代码:TIGER-AI-Lab/GenAI-Bench。数据集:TIGER-Lab/GenAI-Bench(CC-BY-4.0)。
WorldFoundry 归一化官方结果行。一行必须有 task(image_generation / image_editing / video_generation)、人工标签(human_label / human_preference)和裁判预测(prediction / judge_prediction)。它不生成偏好标签。
评测维度
- 图像生成类型任务
图像生成任务上,裁判预测与人工偏好标签的成对准确率。
- 图像编辑类型任务
图像编辑偏好上的成对裁判准确率。
- 视频生成类型任务
视频生成偏好上的成对裁判准确率。
数据组成
- 规模
TIGER-Lab GenAI-Bench / GenAI-Arena 偏好对:图像生成、图像编辑与视频生成,带人工标签。
- 来源
TIGER-Lab/GenAI-Bench · github.com
- 模态
image · video · text
- 许可证
cc-by-4.0
- 说明
这是在评裁判与人类是否对齐。WorldFoundry 不生成偏好标签。
指标
指标
- 方向越高越好
pairwise_accuracyGenAI-Bench 各任务上与人工偏好标签的成对准确率。
- 方向越高越好
image_generation_preference_accuracyGenAI-Bench 图像生成偏好与人工标签的一致准确率。
- 方向越高越好
image_editing_preference_accuracyGenAI-Bench 图像编辑偏好与人工标签的一致准确率。
- 方向越高越好
video_preference_accuracyGenAI-Bench 视频生成偏好与人工标签的一致准确率。
- 方向越高越好
genai_bench_average任务级标签与预测齐备时各任务偏好准确率的均值。
主指标GenAI-Bench average
Leaderboard
论文报告结果(非实时榜;不是 WorldFoundry 跑分)。 衡量的是评判模型与人类偏好的对齐,不是生成模型画质榜。官方数据集卡片快照日期 2024-08-09。 GenAI Arena: An Open Evaluation Platform for Generative Models (2024).
| 模型 | 成对准确率平均(test_v1) |
|---|---|
| GPT-4o | 49.2 |
| Gemini-1.5-Pro | 48.94 |
| LLaVA | 31.17 |
| Idefics2 | 28.67 |
| Random | 25.47 |
如何运行
worldfoundry-eval zoo benchmark-run \
  --benchmark-id genai-bench \
  --mode official-validation \
  --official-results-path <official_results.jsonl> \
  --generated-artifact-dir <generated_videos> \
  --output-dir tmp/genai-bench/official-validation \
  --json
--preference-pairs-path 提供成对清单。默认导入路径:WORLDFOUNDRY_GENAI_BENCH_RESULTS_PATH。共享资源:genai_bench_dataset_assets、t2v_metrics_source_assets。
仓内指针:worldfoundry/data/benchmarks/tasks/external/genai-bench.yaml。
产物包括 scorecard.json(主键 genai_bench_average)、benchmark_contract.json、raw_metric_table.jsonl。