欢迎使用 WorldFoundry
WorldFoundry
面向世界智能的通用基础设施
一条工作流
- 模型发现、推理、检查与评测对齐同一套世界模型操作定义
- TUI、CLI、Studio、Python 与 MCP 共享 request 与 artifact 契约
- 申请 GPU 或下载权重前,可先查看 manifest、needs 与 blocker
- 持久 artifact 支持后续 review、重新打分与证据复用
- Python API 参考由源码签名与 docstring 自动生成
广覆盖、边界清晰
- 275 个模型条目与 74 个可浏览的 benchmark,readiness 信号明确可见
- 保留视频、3D/4D、交互世界与具身栈的原生 runtime
- Benchmark 只评测输出,不接管模型加载
- 生成与打分可按需拆到不同环境执行
- Scorecard 记录 provenance、覆盖率、blocker 与结果能支撑何种声明
- CLI 是集成状态与 next_action 的权威来源
WorldFoundry 是面向世界智能的开源基础设施。世界智能不能被压成单一的生成任务:系统需要从观察中推断结构化状态,预测状态如何演化,用任务相关的输出表达后果,并在交互中使用这些预测。视频生成、神经场景表征、4D 模型与具身策略各自覆盖其中一部分。
模型发现、runtime 与资产准备、推理、artifact 检查和 benchmark 证据走同一条工作流,覆盖这些家族——同时不被强迫接受同一种表征、任务或指标。
第一次运行
快速开始 的环境已经 source 之后,为 matrix-game-2 生成一份可检查的 artifact:
bash scripts/inference/prepare_model_infer.sh matrix-game-2 --download
worldfoundry-eval run matrix-game-2-universal-action-validation \
  --pipeline.task-profile official-universal-image
这次运行只支撑一个结论:这套配置产出了可检查的 artifact,并不等于某个 benchmark 已经跑完。日常命令用 worldfoundry-eval run。各层与清单见设计。
操作定义
视觉逼真度衡量的是观察质量,并不足以证明世界建模。一段照片级视频仍可能丢掉物体身份、违反动力学,或对干预没有因果响应。
因此,我们把生成式世界模型定义为一个学习得到的、由历史与控制条件化的潜在动力学系统。它推断并维护持久的环境状态,在内生动力学与外部干预下演化该状态,并吸收新的观察,使后续预测对刚刚发生的事情负责。
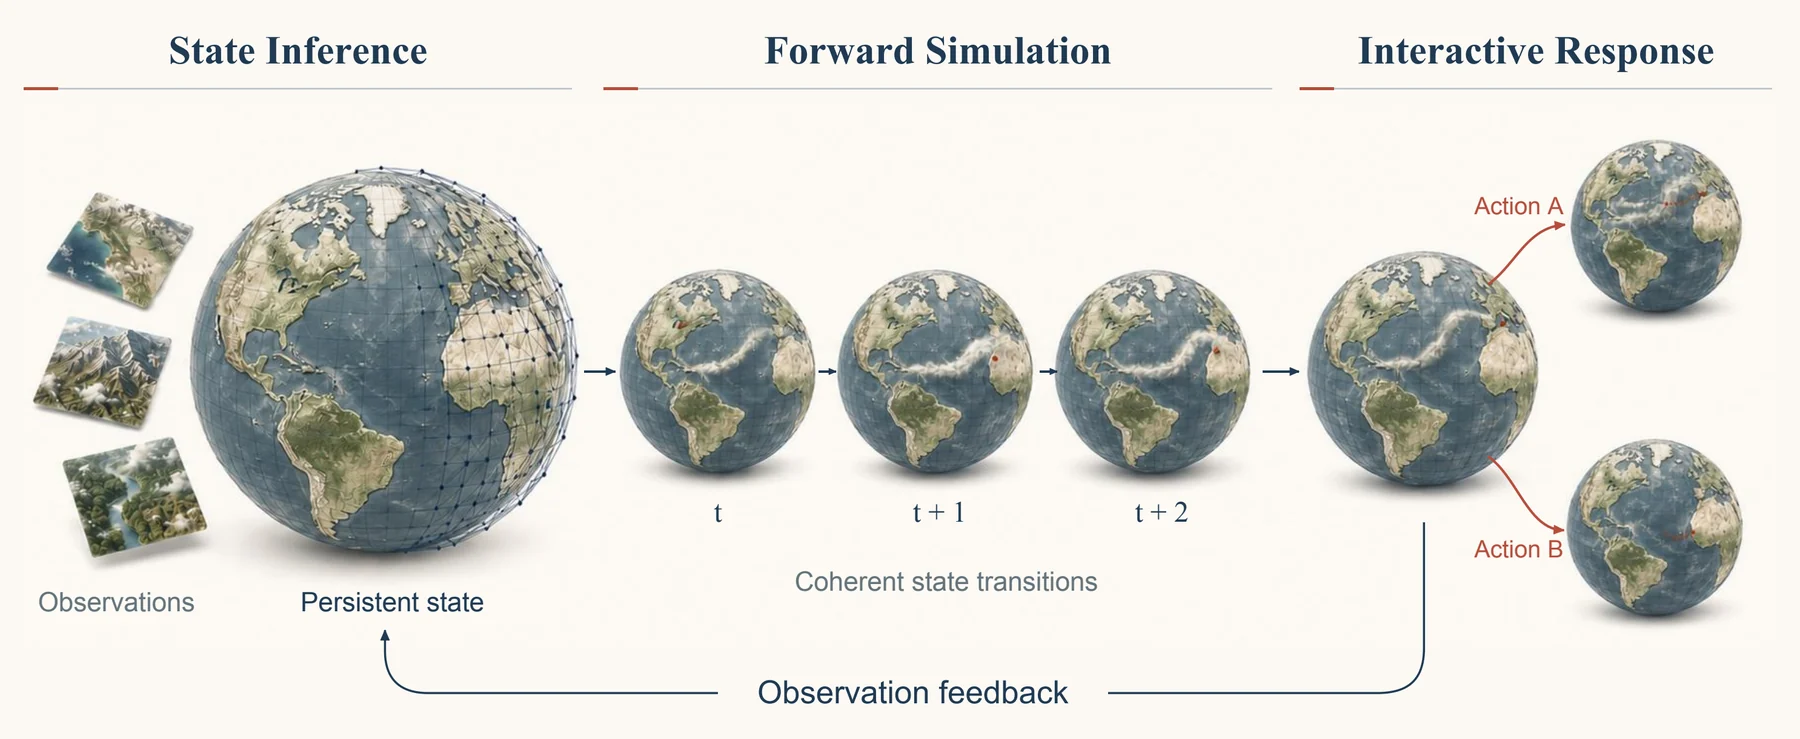
定义能落地,是因为三件事必须耦合:
- 状态推断 — 从交互历史中估计任务相关的潜在状态。
- 前向仿真 — 在自主动力学、物理约束与动作下预测该状态如何演化。
- 交互响应 — 在不同干预下产生可区分且连贯的未来,再把观察到的结果写回所维护的状态。
一个与模态无关的紧凑形式是
其中 是观察–控制历史, 是动作或干预(包括空控制), 是推断出的环境状态, 是视觉、几何或任务相关输出。这是功能抽象,不是架构断言: 可以是循环的、物体中心的、几何的、token 化的,或其他结构化形式。
从同一推断状态出发,具有不同环境后果的控制应诱导出可区分但连贯的 rollout;干预范围之外的因素应继续服从同一条件动力学。新的观察必须更新此后使用的状态。
能力分层
WorldFoundry 并不给每个模型贴一个互斥等级,而是记录能力剖面:系统实际支持哪些功能,以及这些功能是否耦合。
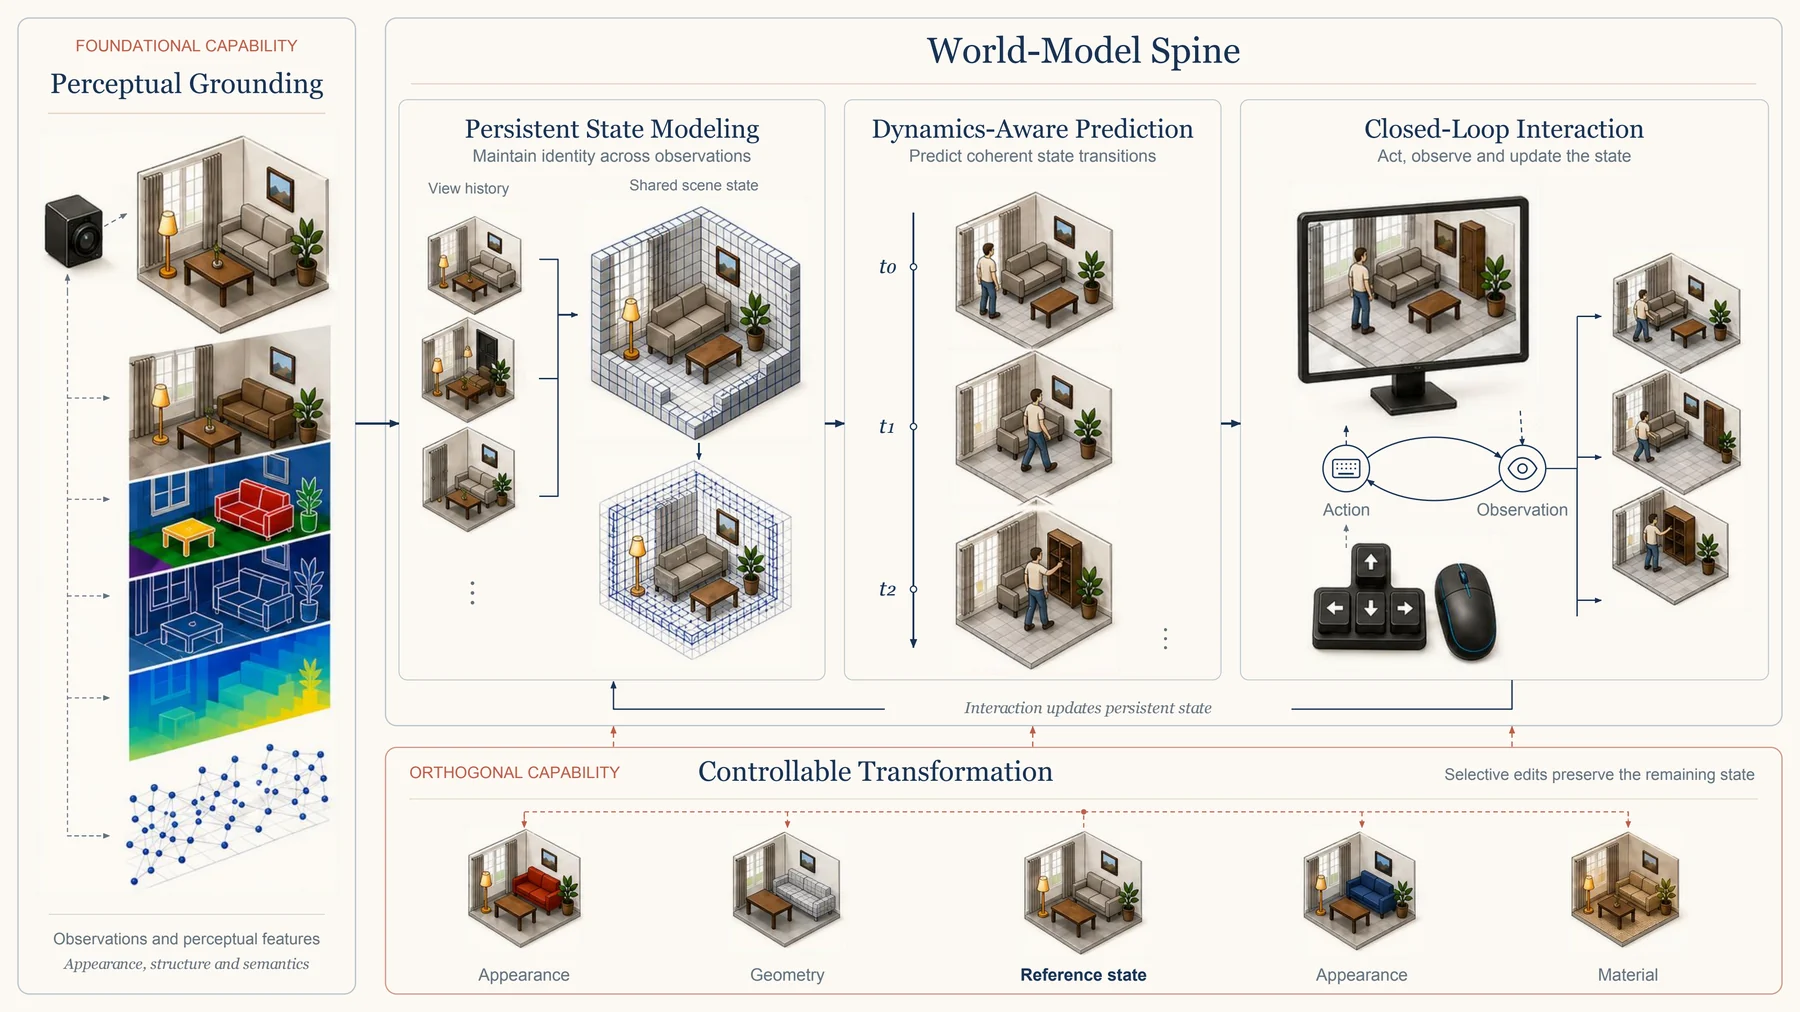
感知锚定
解释、重建或合成观察。它为状态推断提供感知基础,但本身还不等于对环境的持久表征。
世界模型主轴
持久状态 → 动力学预测 → 交互反馈
持久状态
从序列观察中推断并维护结构化环境状态,跟踪身份、几何、空间关系与部分可见条件下的属性。
动力学
按物理与因果规律预测状态转移,使内生过程、动作与干预的后果在后续轨迹中持续约束预测。
闭环交互
在同一环境中循环执行动作、观察与状态更新。反馈修正当前状态,再条件化下一步预测。
可控变换
按指定控制改写表征中的内容,同时保持其余结构。它可以增强主轴上的任一阶段,但单独成立并不足以证明动力学或闭环交互。
感知锚定提供观察层证据。真正构成世界模型的是主轴上的耦合:持久状态、受干预条件化的动力学,以及由反馈驱动的更新。可控变换可以出现在任一阶段旁边——改沙发颜色或删掉书架,本身并不能证明系统能把场景向前推演,或闭合交互环。
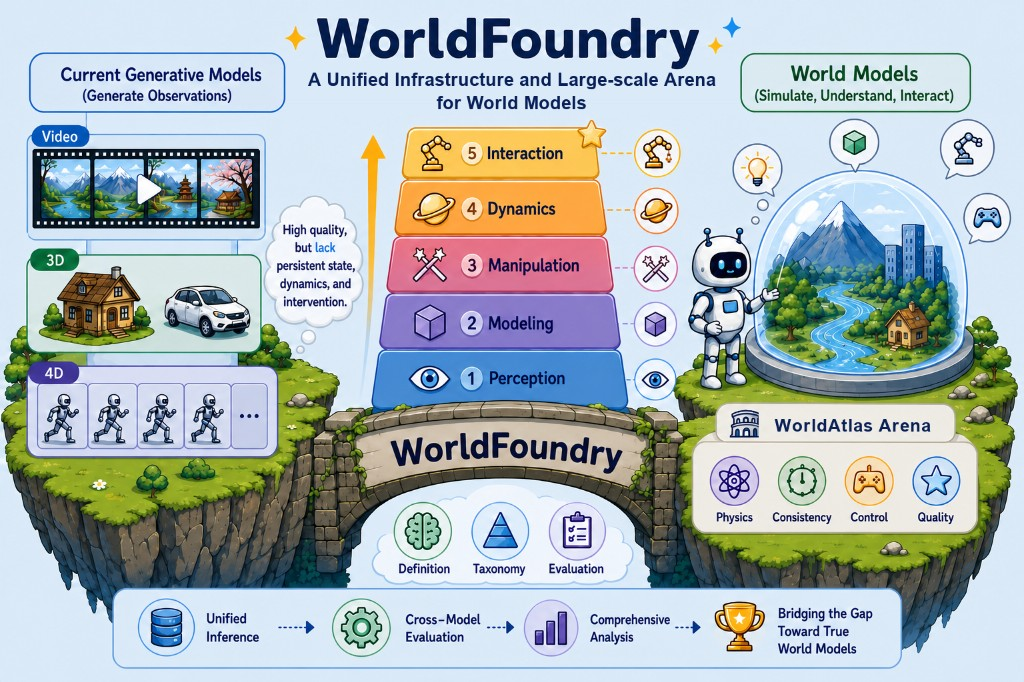
基础生成模型与生成式世界模型
这是功能分类,不是视觉质量排名。
基础生成模型学习视觉、几何或时空先验,用于合成、重建与可控编辑。它们可以在外观、短时连贯或选择性编辑上很强,但没有把状态、动力学与反馈集成成完整的世界建模环。
生成式世界模型集成了这个环。干预效果会在后续转移中保持,新的观察会修正此后预测所依赖的状态。更高保真度、更宽的 prompt 或更大的规模,本身并不会把系统从第一类提升到第二类。
正因为如此,WorldFoundry 把 catalog 收录、可运行推理、可检查 artifact 与可进入 benchmark 的证据分开记录。一次好看的 demo 仍然可能只是感知锚定。当前覆盖范围和 readiness 以模型目录与评测中心为准。被 catalog 收录,不等于 runtime 能跑;demo 效果好,不等于已有 benchmark 证据;分数导入成功,也不等于官方 leaderboard 水平。这些状态分开记录,并保留 provenance。
为什么需要共享工作流
WorldFoundry 的价值出现在跨模型、跨 benchmark、跨界面的工作流里。技术报告把这一点表述为可通约而不均质化:异构系统应能在共享的运行与证据契约下被检查,而不被强迫接受同一种表征、任务或指标。
因此才需要这条共享工作流:
- 统一的运行语义。 稳定的 model ID 与 benchmark ID,加上 request、result、artifact、manifest 与 scorecard,替代仓库昵称和手写路径。可以查证模型只是被收录还是真的执行过、用了哪个 checkpoint 与 runtime、sample 是否覆盖,以及分数是归一化、官方计算,还是已经过 leaderboard 校验。
- 集成只做一次。 环境准备、checkpoint 查找、输入输出整理、job 记录、预览与 metric 汇总保持共享。模型差异留在 pipeline 与 operator,benchmark 差异留在 runner 与 metric。
- 产物可复用。 生成结果不绑定于一次 UI 会话。同一批 artifact 可以检查、重新打分、转换、对照或审计,而不必再加载模型。
- 记录比命令更完整。 checkpoint、依赖、dataset 或 evaluator 一变,同一条命令就可能不可比。ledger、身份、blocker 与 scorecard 同时说明实际跑了什么,以及该结果被允许主张什么。
- 多入口,同一后端。 TUI、CLI、Studio、Python 与 MCP 共用 catalog 与契约。界面可以换,run 身份与持久输出保持一致。
这适合需要长期维护或比较多个世界模型家族、将生成与评测解耦、复用昂贵 artifact,或为人与 agent 提供稳定机器可读发现的团队。模型、benchmark、机器与 reviewer 越多,这些契约越划算。
致谢
WorldFoundry 集成并适配了上游世界模型、视频生成、感知、重建、具身动作与评测项目。每个 catalog 条目都会保留各自的来源与许可证元数据。
基础设施依赖
- FastVideo面向加速视频生成的统一推理与后训练框架。
- OpenWorldLib面向高级世界模型的统一代码库。
- VLA Evaluation Harness在机器人仿真 benchmark 上评测 VLA 模型的框架。