TUI 指南
如何使用终端界面(TUI)进行发现、配置和命令生成。
终端界面(TUI)是一个跑在终端里的交互式文本面板。它是浏览模型与 benchmark catalog、检查 readiness、生成 CLI 命令最省事的方式,不必记住各种参数。
启动 TUI
启动之前先确认 WorldFoundry 包已安装。首次 CUDA 安装与快速开始相同,使用官方 bootstrap:
bash scripts/setup/bootstrap_worldfoundry.sh
source tmp/worldfoundry_unified_env.sh
conda activate "${WORLDFOUNDRY_UNIFIED_ENV_PREFIX}"
如果自己管理 conda 环境,在仓库根目录安装带 [tui] extra 的包:
python -m pip install -e ".[tui]"环境激活后启动 TUI:
worldfoundry-eval tuiTUI 读取的 model-zoo 与 benchmark-zoo manifest 和 CLI 发现命令完全相同。它不会绕过 manifest readiness、runtime profile 或 runner 验证。
启动选项
参数
--catalog-json打印 TUI 使用的 catalog payload 后退出。
--model-id openvla预选一个模型,跳过模型选择器。
--benchmark-id libero预选一个 benchmark,跳过 benchmark 选择器。
--print-command把生成的
run命令打印到 stdout 并退出,不进入交互式会话。
示例——为指定的 model × benchmark 组合生成命令后退出:
worldfoundry-eval tui --model-id openvla --benchmark-id libero --print-command这在脚本或 CI 流水线中很有用:只要标准命令,不需要人工交互。
浏览与操作
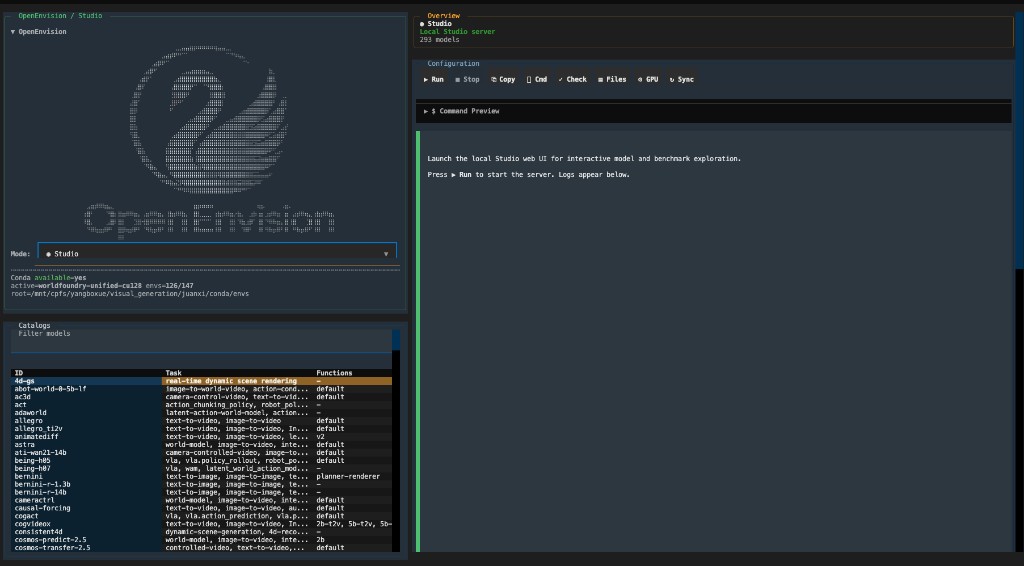
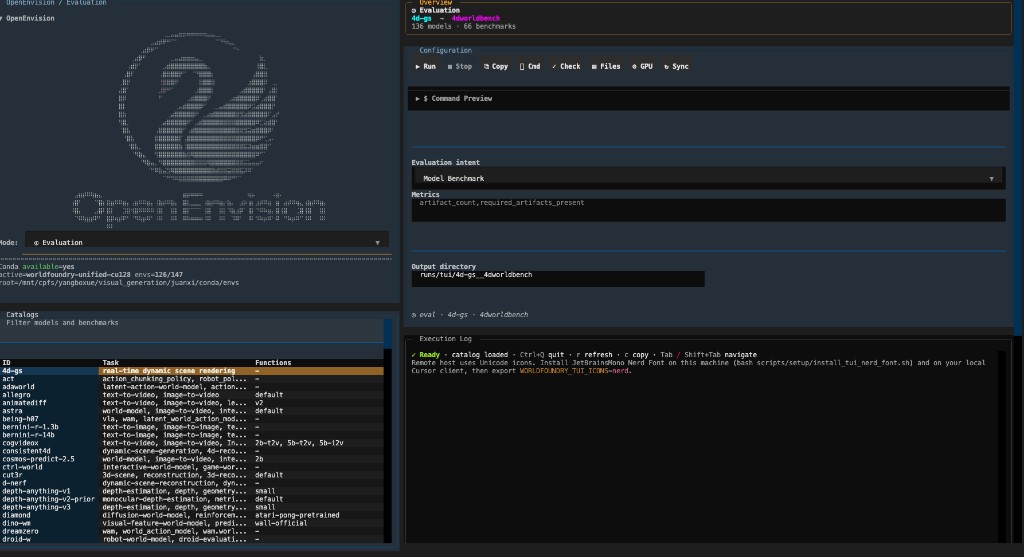
TUI 是一个四栏面板。左侧显示 OpenEnvision 标识、当前 conda 环境,以及可搜索的 Catalogs 表;右侧是当前模式的概览、操作工具栏、参数表单与 Execution Log。
在左上角切换 Mode,可以在 Inference、Studio、Evaluation 三种模式间切换。三种模式共用同一份 catalog 数据,但提供的控件和生成的命令不同。
Inference(推理)
Inference 用于选择模型、填写模型相关输入,并生成可执行的 worldfoundry-eval run 命令。工具栏提供 Run、Stop、Copy、Cmd、Check、Files、GPU、Sync。日常可复现 / 模型页命令用 worldfoundry-eval run;Workspace 视觉冒烟用 python -m worldfoundry.studio.workspace_job infer。入口对照见 CLI 命令入口。
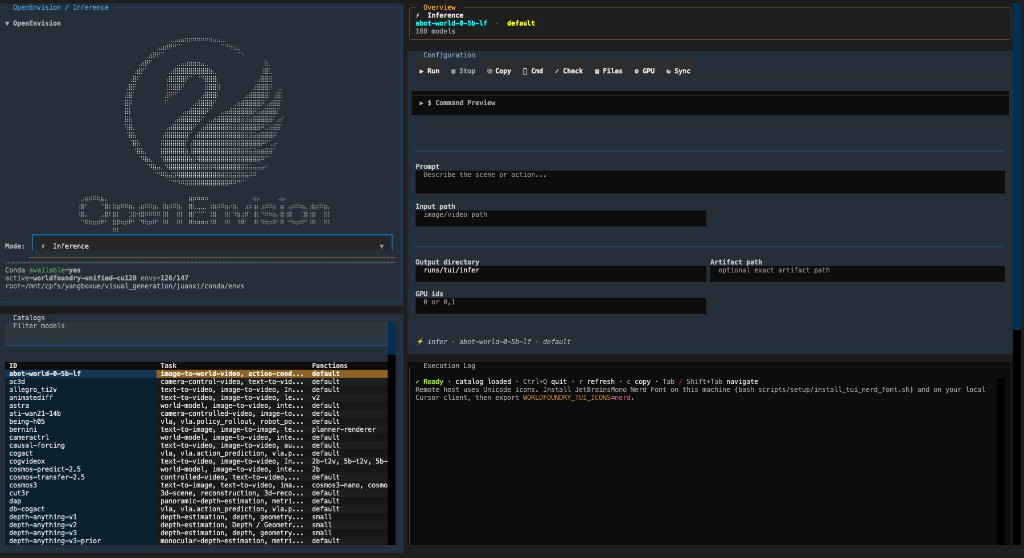
常见字段包括 prompt、输入路径、输出目录、可选 artifact 路径和 GPU ID。Command Preview 会随参数修改实时更新。
Studio
Studio 用于从终端启动本地 Studio Web UI。按 Run 启动服务,状态与日志显示在执行日志中。
Evaluation(评测)
Evaluation 用于配置 benchmark run。选择评测意图、metric 和输出目录后,TUI 会为当前 model × benchmark 组合生成对应的 worldfoundry-eval 命令。
文本框聚焦时,主导航快捷键仍然可用:
快捷键
- Ctrl+F
聚焦 catalog 搜索
- F2
聚焦当前可见的模型或 benchmark catalog
- F3
聚焦配置 tabs;用方向键切换
- F4
展开并聚焦执行日志
- Ctrl+RCtrl+S
运行 / 停止当前命令
- Ctrl+D
在 WorldFoundry 配套的浅色 / 深色主题间切换
- Ctrl+Q
退出
- TabShift+Tab
在控件间移动
- Enter
选中高亮的 catalog 行
文本框外,r 刷新 catalog,c 复制命令,p 检查路径与环境,g 显示 GPU 状态,a 列出输出文件。工具栏 tooltip 也会说明这些操作。
参数配置
Evaluation 模式提供两个明确的意图:
- Model Benchmark — 选择模型与 benchmark,生成从模型推理到官方 benchmark 的端到端命令。
- Score Artifact Directory — 选择 benchmark 和已有 artifact 目录;此时隐藏模型选择与 metric 子集,因为会执行该 benchmark 的完整 protocol。
Inference 模式展示模型相关参数,例如:
- 步数 / 迭代次数 — 去噪或采样步数。
- 引导系数 / cfg — classifier-free guidance 强度。
- 序列长度 — 最大 token 或帧数。
- 种子 — 确定性生成 seed(可选)。
在 TUI 中改动参数会实时更新生成的命令。当自定义 dataset manifest 需要的字段多于 TUI 暴露的范围时,改用 Workspace 或 generate-score CLI。
就绪指示器
TUI 会在 catalog 条目旁显示 readiness 警告:
- 缺失 checkpoint — 模型需要的 checkpoint 不在声明路径上。
- 缺失 dataset — benchmark 需要的 dataset 尚未准备到本地。
- 缺失环境 — runtime profile 声明的 conda 包或 CUDA 版本未满足。
- License 限制 — 模型或 dataset 带 gated 或非商业 license,需要人工确认。
存在 readiness blocker 时,生成的命令默认带上 --mode official-validation。这样可以先验证链路是否接通,而不必为一个被阻断的 run 占用 GPU。
回退模式
未安装 Textual 依赖时,TUI 会打印一份静态回退摘要,替代交互式面板。回退摘要列出 model ID、benchmark ID 和简短的 readiness 说明。
要恢复完整的交互式 TUI,安装 [tui] extra:
python -m pip install -e ".[tui]"