Studio
启动和使用用于 pipeline preview、streaming 和交互式世界模型调试的多前端 Studio。
介绍
WorldFoundry Studio 是围绕仓库 pipelines 的薄可视化入口。模型在启动时固定;切换模型族时启动新进程。
Studio 现在有多前端入口:
world— 交互世界模型。独立 WebRTC 控制台:常驻模型、可靠按键边沿 DataChannel、有界内存帧队列、单一持续视频轨、沉浸式全屏和实时运行日志;控制热路径不生成 MP4。points— Viser 点云 / mesh。直接启动原生 Viser,不嵌回游戏机界面。embodied— 具身智能仿真器。计划中。 目前只是 URL bridge:Studio 登记外部 simulator URL 并给出 tunnel 提示,还没有仓内 embodied viewer。spark— 3DGS。启动独立 Spark 3DGS viewer,复用项目内置 Spark frontend,并允许通过WORLDFOUNDRY_MODEL_DIR/WORLDFOUNDRY_ARTIFACT_DIR暴露本地资产。media— 视频、图片与音频产物预览。rerun— Rerun recording 与时间线查看。auto— 默认。按模型类型自动路由:交互世界 ->world,3D scene ->spark,点云/深度 ->points,具身策略 ->embodied。
可视化内容
- World 控制台 — 实时画面、键盘和摇杆、沉浸式全屏与运行日志。
- 几何查看器 — Spark 查看 Gaussian splat,Viser 查看点云和 mesh。
- Workspace — 任务状态、媒体预览、产物下载与可视化前端启动。
Workspace 模式
多模型验证和发布 QA 推荐启动 workspace app,而不是单模型 Studio 进程:
source tmp/worldfoundry_unified_env.sh
conda activate "${WORLDFOUNDRY_UNIFIED_ENV_PREFIX}"
bash scripts/workspace/run_workspace.sh \
--host 127.0.0.1 \
--port 7870 \
--max-jobs 8如果 checkpoint 或 benchmark 数据不在默认 cache 中,显式传入根目录:
bash scripts/workspace/run_workspace.sh \
  --ckpt-dir /path/to/checkpoints \
  --data-dir /path/to/benchmark-data
launcher 不依赖任何机器专有路径。资产解析顺序是:命令行参数、已经导出的
环境变量、repo 同级存在的 ckpt/ 或 data/ 目录、tmp/worldfoundry_unified_env.sh
中的 env-file 值,最后回退到 ~/.cache/worldfoundry/...。
首次 CUDA 安装与快速开始相同,使用官方脚本 bash scripts/setup/bootstrap_worldfoundry.sh。
Workspace 必须从模型推理使用的统一 runtime 环境启动,不能从只装了 UI
依赖的轻量环境启动。CUDA 12.8 机器通常对应
worldfoundry-unified-cu128,先执行 source tmp/worldfoundry_unified_env.sh
再启动 7870。如果 LOAD 或 START 报 cv2 等模块缺失,说明当前
7870 进程不是统一 runtime 环境,先重启 workspace,再排查模型代码。
不要在机器之间复制或搬迁已经创建好的 conda 环境。Python、OpenSSL 等原生
链接可能仍指向旧 prefix,导致浏览器服务能启动,但 resident inference worker
一运行模型就报缺少 python3.x、cv2、libssl 或 libcrypto。遇到这类
问题,按公开 setup 路径验证或重建统一环境:
bash scripts/setup/bootstrap_worldfoundry.sh --verify-only
source tmp/worldfoundry_unified_env.sh
bash scripts/workspace/run_workspace.sh
打开:
http://127.0.0.1:7870/workspace 是发布验证时推荐使用的 UI。
它适合提交 inference job、检查不同模型的输入表单、查看生成产物,
以及在同一个界面里对比多次 run。
这些 Workspace job 是视觉冒烟(python -m worldfoundry.studio.workspace_job infer)。日常可复现 / 模型页命令用 worldfoundry-eval run <id> --pipeline.task-profile …。入口对照见 CLI 命令入口。
Workspace 也支持 evaluation job。以 VBench 为例:选择 Evaluation,
benchmark 选 vbench,把生成视频目录填到 Dataset Root(或把官方
VBench results JSON 填到 Results Path),Metrics 填一个或多个
dimension,例如 aesthetic_quality、motion_smoothness,也可以填 preset
custom_supported。VBench 专用 runtime 参数,例如
{"mode":"custom_input","load_ckpt_from_local":true},写到 Eval Runtime JSON。
Create Job 配置
Workspace UI 没有单独的 Settings 页。每次提交前在 Create Job 对话框里 定制参数即可。
- Model / variant / task profile — 选择 catalog 条目,以及该模型暴露的官方输入 contract。
- Prompt、input path、动态 task 字段 — 来自 inference contract 的模型专用输入。
- Device、backend、attention — 运行设备与加载路径(
auto、from_pretrained、api_init)。 - Frames、FPS、height、width、steps、guidance、seed — 写入 job payload 的生成参数。
- Runtime checks — 可选内存/编译开关,例如 Torch Compile、CPU Offload、VAE Offload、Text Encoder Offload;仅在所选模型声明支持时显示。
- Call JSON / Load JSON — 合并进
call_kwargs和load_kwargs的高级 override。
打开 Create Job 或切换 task profile 时,表单会先用 Workspace 启动时加载 的默认值预填。catalog 和 task profile 中的模型专用官方 demo 值仍优先于这些 共享默认值。
未配置 settings 文件时的默认值:
Key
device默认
cuda;若设置了WORLDFOUNDRY_STUDIO_DEVICE则使用该值- 默认
backendauto - 默认
attention_backendauto - 默认
fps16 - 默认
num_frames81 heightwidth默认
720×1280- 默认
num_inference_steps30 - 默认
guidance_scale7.5 - 默认
seed-1 - 默认
torch_compilecpu_offloadfalse
可选的持久化默认值
若希望在 Workspace 重启后仍复用同一套默认值,可指定 JSON settings 文件:
export WORLDFOUNDRY_STUDIO_SETTINGS_FILE=/path/to/studio-settings.json启动时 Workspace 会把该文件加载到 /api/settings,Create Job 表单通过
GET /api/settings 读取。运维脚本也可以用 POST /api/settings 更新:
curl -sS -X POST http://127.0.0.1:7870/api/settings \
  -H 'Content-Type: application/json' \
  -d '{"values":{"fps":12,"num_frames":49,"attention_backend":"torch"}}'
未设置 WORLDFOUNDRY_STUDIO_SETTINGS_FILE 时,默认值只存在于当前 Workspace
进程内存中,重启后会恢复为内置默认。
快速 job 与 preflight 检查
Workspace inference 默认走快速 job 路径:默认认为 conda 环境、checkpoint 根目录和 viewer 依赖已经在启动 server 前配置好。正常反复推理时建议保持默认。
只有在环境排障或发布前 preflight 时,再显式打开检查:
环境变量
WORLDFOUNDRY_STUDIO_RUNTIME_CHECKS默认 跳过
设为
strict时,在 pipeline load 前验证 runtime imports 和本地 model path。WORLDFOUNDRY_STUDIO_CHECK_RUNTIME_COMPLETENESS默认 跳过
设为
1时,构建 Studio catalog 会重新检查仓内 3D/4D entrypoint 文件。- 默认
WORLDFOUNDRY_STUDIO_RESIDENT_WORKERSauto设为
0时关闭长驻 conda worker,恢复每个 job 单独启动子进程。 WORLDFOUNDRY_STUDIO_RESIDENT_WORKER_MODELS默认 所有符合条件的模型
只给指定模型启用 resident worker,例如
matrix-game-2;torchrun/多卡 job 仍走一次性子进程。- 默认
WORLDFOUNDRY_STUDIO_ARTIFACT_SCAN_MODEmissingrun record 缺少 required artifacts 时才扫描输出目录。
- 取值
WORLDFOUNDRY_STUDIO_ARTIFACT_SCAN_MODEalways对未返回 artifact paths 的旧 runtime 强制递归扫描输出目录。
- 取值
WORLDFOUNDRY_STUDIO_ARTIFACT_SCAN_MODEoff完全不扫描输出目录,只相信
preview_*、artifact_paths和rrd_path。 WORLDFOUNDRY_STUDIO_VALIDATE_PREVIEW_VIDEO默认 跳过
设为
1时,接受 preview video 前先尝试解码。WORLDFOUNDRY_STUDIO_EXTRACT_VIDEO_PREVIEW_IMAGE默认 跳过
设为
1时,从生成视频中抽取静态 preview image。WORLDFOUNDRY_STUDIO_BUILD_RERUN_PREVIEW默认 跳过
设为
1时,对 geometry 输出自动构建.rrdpreview。
为了让 job 完成路径最快,模型 runtime 应该在 run record 中显式返回
preview_image、preview_video、artifact_paths、rrd_path 和 output_dir。
只有旧 runtime 只写文件、不返回路径时,才建议把 artifact scan mode 切到
always。
Resident worker 会让 conda 子进程在多个 job 之间保持存活,因此子进程里的
StudioManager 可以复用 pipeline cache。排查进程启动问题,或希望每个 job
结束后立刻释放 GPU 显存时,设置 WORLDFOUNDRY_STUDIO_RESIDENT_WORKERS=0。
Visualizers、Gallery 和 Artifacts 适合快速视觉 QA。 这些视图会展示最近生成的视频、图片、manifest 和直接 artifact 链接。 真正对外声明验证通过前,还需要把对应 run 记录到模型推理验证页。
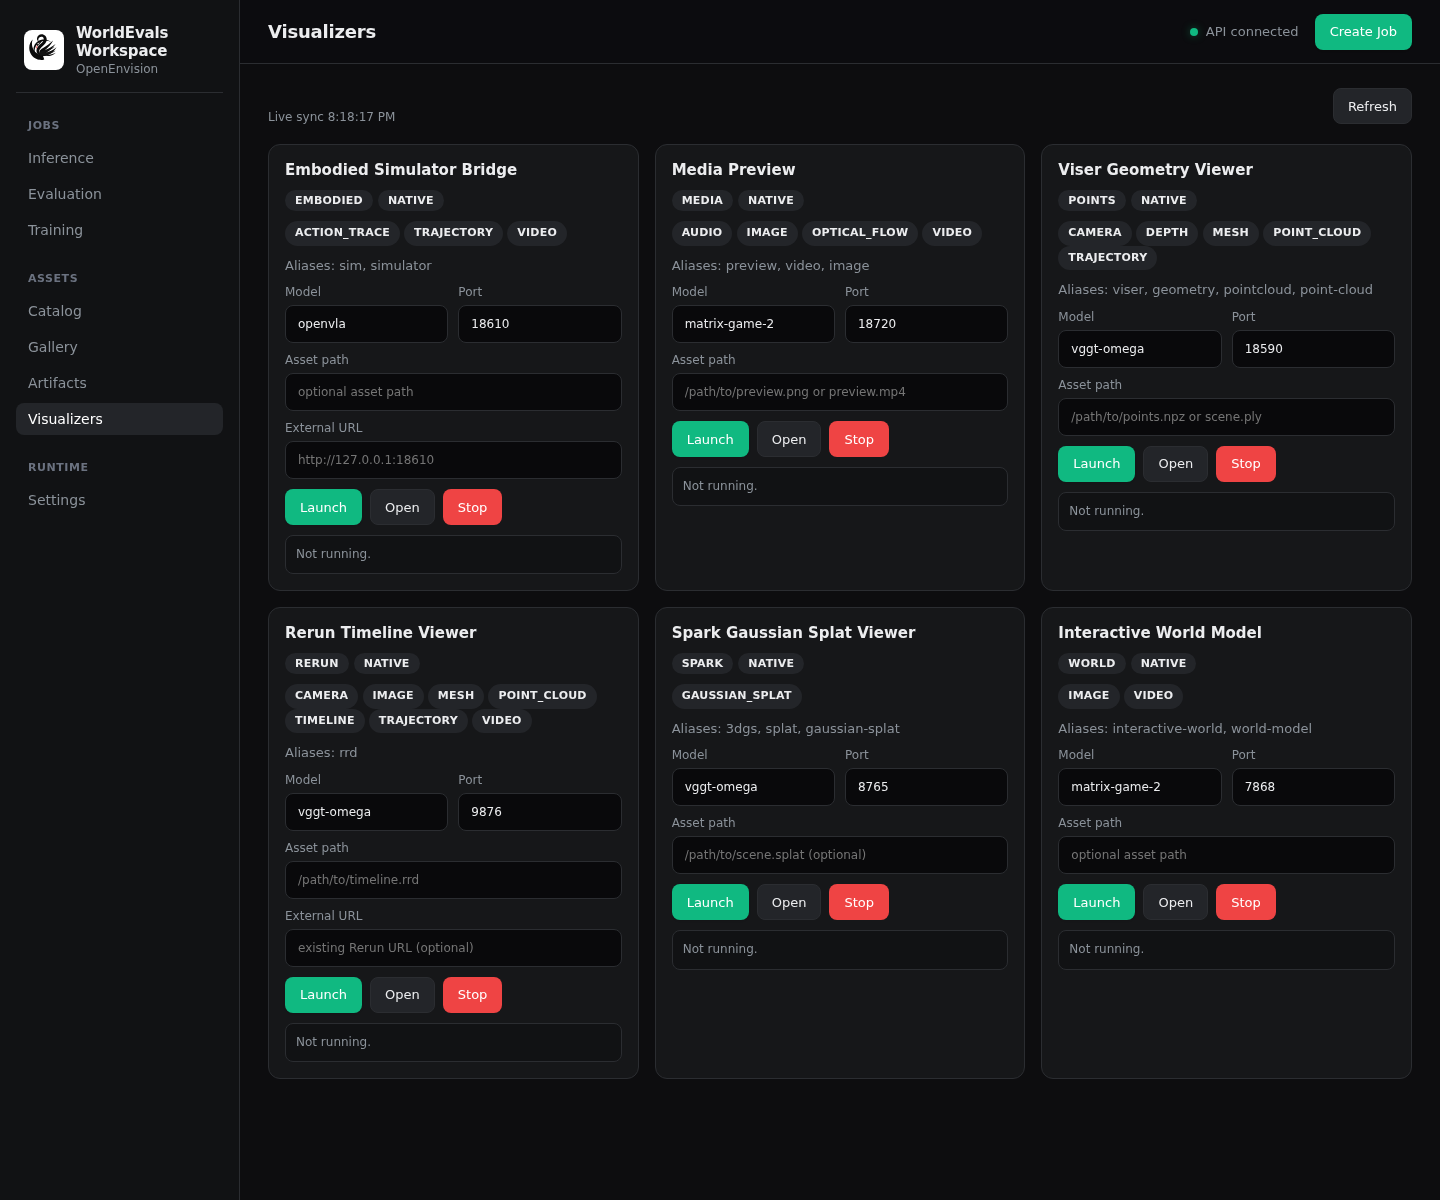
Workspace 可视化入口
7870 Workspace 是整套可视化服务的统一浏览器入口。打开 Visualizers
页面后,每张卡片都有 Launch、Open 和 Stop 按钮。卡片下方会
嵌入正在运行的 viewer iframe,普通 QA 流程里不需要手动复制 URL。
具身仿真器不是 Workspace visualizer。--frontend embodied 只会登记外部
simulator URL 并打印 tunnel 提示;请先单独启动 simulator,再传入
--simulator-url。
世界模型分段 Rollout
面向实时漫游的缓冲式动作条件 rollout。前端持续采样控制输入并预取生成片段。
端口 7868产物 image, video, action_trace
启动
python -m worldfoundry.studio.cli matrix-game-2 --frontend world --port 7868Viser Geometry Viewer
点云、depth 转 point set、mesh、camera pose 和 trajectory。
端口 18590产物 ply, pcd, xyz, glb, gltf, obj, npz
启动
python -m worldfoundry.studio.cli pi3 --frontend points --asset /path/to/scene.plyRerun Timeline Viewer
`.rrd` timeline / recording,同步 camera、frame、track 与 3D entity。
端口 9876产物 rrd
启动
python -m worldfoundry.studio.cli vggt --frontend rerun --asset /path/to/recording.rrdSpark Gaussian Splat Viewer
通过仓内 Spark frontend 查看 3D Gaussian splat。实时预览来自 Spark.js Hello World butterfly demo。
端口 8765产物 splat, spz, ksplat, sog, splat-ply
启动
python -m worldfoundry.studio.cli vggt --frontend spark --asset /path/to/scene.splat
world 默认使用 7868。只有部署环境要求固定代理路由时,才需要手动指定端口。
实时前端需要 worldfoundry[studio_realtime](worldfoundry[ui] 已包含)。
服务启动时会后台加载模型;一次会话固定复用同一个 pipeline context 和执行线程。
WASD/IJKL 只发送按下/释放边沿,服务端按生成 chunk 重采样;RGB 帧直接进入
WebRTC 视频轨。控制到画面的热路径不会扫描 artifact、写 manifest 或编码 MP4。
延迟相关默认值可以单独调整,不必改 catalog 质量配置:
播放与生成
- 默认16
WORLDFOUNDRY_REALTIME_FPSWebRTC 播放节奏与输入重采样频率。
- 默认9
WORLDFOUNDRY_REALTIME_CHUNK_FRAMES每个生成 chunk 的目标帧数;有严格时序约束的模型会覆盖该值。
- 默认模型默认;LingBot Fast 为 4
WORLDFOUNDRY_REALTIME_INFERENCE_STEPS显式的延迟/质量覆盖;非蒸馏模型不会被静默降到 4 步。
- 默认1
WORLDFOUNDRY_REALTIME_WARMUP_CHUNKS后台 stream warmup;设为 0 可关闭,编译/autotune 实验可调高。
- 默认未设置
WORLDFOUNDRY_REALTIME_PREWARM_TIMEOUT_SECONDSconfigure 与 warmup chunks 的可选 deadline;当前不可取消的模型调用返回后才报告超时,设为 0 可关闭。
队列与呈现
- 默认max(chunk, 8)
WORLDFOUNDRY_REALTIME_FRAME_QUEUE单个 steady-state chunk 的有界播放队列。
- 默认latest-interactive
WORLDFOUNDRY_REALTIME_FRAME_QUEUE_POLICYlatest-interactive 在拥塞时限制延迟,ordered-quality 保留每一帧;严格计数的 prompt/segment 会话始终强制使用 ordered-quality。
- 默认hold-last
WORLDFOUNDRY_REALTIME_PRESENTATION_MODEWebRTC A/B 开关。hold-last 保留兼容的恒定时钟;real-frames 将 pacing 交给 chunk presentation manager,并通过两帧 mailbox 只发送真实帧。
- 默认模型 FPS × 2
WORLDFOUNDRY_REALTIME_PRESENTATION_MAX_FPSreal-frames 模式存在 pending chunk 时,active chunk 的最大 drain 速率。
- 默认legacy-dual
WORLDFOUNDRY_REALTIME_SOCKET_PACING_MODEWebSocket A/B 开关。client-only 关闭服务端逐帧 sleep,仅保留浏览器现有的 presentation clock。
- 默认半个 chunk
WORLDFOUNDRY_REALTIME_BACKPRESSURE_MS正常播放时保留全部帧;只有拥塞超过预算才丢弃旧帧。
RTX 后处理
- 默认identity
WORLDFOUNDRY_REALTIME_POSTPROCESS_PRESET可选 identity、rtx-super-resolution、rtx-super-resolution-ultra 或 rtx-deblur-ultra。RTX 必须显式启用;运行条件不满足时会在启动服务前失败。
- 默认preset 默认值(VSR 为 2,deblur 为 1)
WORLDFOUNDRY_REALTIME_RTX_SCALEVSR 空间放大倍数;NVIDIA VFX 最高支持 4x,同分辨率去噪/去模糊模式必须为 1。
- 默认未设置
WORLDFOUNDRY_REALTIME_RTX_OUTPUT_WIDTHWORLDFOUNDRY_REALTIME_RTX_OUTPUT_HEIGHT可选的 RTX 显式输出尺寸;必须同时设置或同时不设。
- 默认preset 默认值
WORLDFOUNDRY_REALTIME_RTX_QUALITY覆盖 NVIDIA VFX quality 枚举,例如 HIGH、ULTRA、DEBLUR_ULTRA 或 HIGHBITRATE_HIGH。
- 默认Studio device 中的 index,否则为 0
WORLDFOUNDRY_REALTIME_RTX_DEVICEVFX effect 使用的 CUDA device index。
- 默认false
WORLDFOUNDRY_REALTIME_RTX_NON_BLOCKING请求异步 VFX 执行。WorldFoundry 在 clone 借用的 DLPack 输出前仍会同步,不会降低内存安全性。
- 默认true
WORLDFOUNDRY_REALTIME_RTX_USE_CURRENT_STREAM把当前 PyTorch CUDA stream pointer 传给 NVIDIA VFX;只应在排查 stream interop 时关闭。
性能采样
- 默认5
WORLDFOUNDRY_REALTIME_PERF_LOG_INTERVAL_CHUNKS每 N 个 chunk 输出一次含各阶段 p50/p90 的结构化 timing 摘要;设为 0 可关闭周期摘要。
- 默认0
WORLDFOUNDRY_REALTIME_PERF_WARMUP_CHUNKS将会话开头 N 个 chunk 标记为 warmup 并从摘要中排除;原始 JSONL 仍保留 warmup 标记。
- 默认未设置
WORLDFOUNDRY_REALTIME_PERF_JSONL可选的 JSONL 路径,每个 chunk 写一条规范化 realtime.chunk_timing 事件;仅建议 profiling 时启用,避免热路径文件 I/O。
会话与网络
- 默认30
WORLDFOUNDRY_REALTIME_LIVENESS_TIMEOUT_SECONDS浏览器 heartbeat 消失后自动回收会话,同时避免误杀较慢的在途 chunk。
- 默认5
WORLDFOUNDRY_REALTIME_SHUTDOWN_TIMEOUT_SECONDSpreload、会话 worker、传输层与 runtime reset 共享的协作式异步 teardown 总 deadline;它限制 shutdown handler 的等待时间,但不会强杀仍在运行的模型线程。
- 默认未设置
WORLDFOUNDRY_REALTIME_ICE_SERVERS_JSON浏览器无法直连 GPU 主机时使用的 STUN/TURN iceServers JSON。
可选 NVIDIA RTX 后处理
RTX Video Super Resolution 不进入模型的因果状态:它只在 transport 前处理已经
decode 的 RGB 帧,并保持帧数、顺序、dtype 与数值范围不变。Studio 会把处理后的
尺寸作为 transport 的 Native 分辨率,并从它推导更小的传输选项。由于 nvidia-vfx
使用 NVIDIA 专有许可证,它不会进入默认依赖或 all extra,必须显式安装和启用:
pip install 'worldfoundry[studio_realtime,rtx_postprocess]'

export WORLDFOUNDRY_REALTIME_POSTPROCESS_PRESET=rtx-super-resolution
export WORLDFOUNDRY_REALTIME_RTX_SCALE=1.5
python -m worldfoundry.studio.cli <model-id> --frontend world --device cuda:0
服务启动前,adapter 会检查 package、CUDA 可见性、device index、Turing 或更新
架构的 compute capability,以及 Linux NGX driver library;随后还会加载所选 native
effect 并处理一帧代表性输入,因此 driver image 不完整时会在 Studio 对外服务前失败。
真正调用时,backend 收到连续的 CHW float32 CUDA 帧(范围 [0, 1]);每次调用后
会先 clone 借用的 DLPack 输出,再复用 effect。不启动 Studio 也可以分别执行静态检查
和完整 native probe:
python -c 'from worldfoundry.core.media.processing.rtx import inspect_rtx_vfx_capability as check; print(check(device=0).to_payload())'
python -c 'from worldfoundry.core.media.processing.rtx import probe_rtx_vfx_runtime as probe; print(probe(device=0).to_payload())'
Linux 上的 VideoSuperRes 还需要 libnvidia-ngx.so.1。即使 CUDA 与 nvidia-smi
正常,compute-only/headless driver image 也可能省略它。请从与当前 driver 完全相同
版本的 NGX/OpenGL userspace 组件(通常为 libnvidia-gl-<driver-major>)安装该库,
并在 Python 启动前让 dynamic linker 可见;不要混用不同 driver 版本的库。
支持的 OS 与 driver 版本由 NVIDIA 决定,部署前应核对最新的
NVIDIA VFX Python requirements。VSR 会增加
transport 像素量和 postprocess_ms,因此应按下方门禁做 A/B trace。低延迟交互建议
从 1.5x HIGH 起步;只有实测 GPU 仍有余量时再启用 ULTRA 或 2–4x。
rtx-deblur-ultra 保持原分辨率,不会增加传输带宽。
实时性能回归门禁
先启用原始 timing,完成一次有代表性的交互,再用显式 JSON manifest 检查
最后一个匹配会话。Warmup chunk 会保留在 trace 中用于诊断,但带 warmup=true
的记录不会进入统计。
export WORLDFOUNDRY_REALTIME_PERF_JSONL=outputs/realtime-timing.jsonl
export WORLDFOUNDRY_REALTIME_PERF_WARMUP_CHUNKS=1{
"schema_version": "worldfoundry-realtime-regression-v1",
"cases": [{
"name": "lingbot-webrtc",
"selectors": {"model_id": "lingbot-world", "transport": "webrtc"},
"thresholds": {
"min_chunks": 10,
"min_throughput_fps": 16,
"max_dropped_frames": 0,
"max_queue_depth": 16,
"max_stage_p90_ms": {"generation_ms": 650, "model_ms": 500}
}
}]
}Python 调用方可使用 worldfoundry.runtime.realtime_regression 中的
RealtimeRegressionManifest.read_json() 加载此文件,使用
read_realtime_trace() 读取 trace,再将两者传给
evaluate_realtime_manifest()。结果包含每个实际值、比较符和阈值,
也可转换为统一的 PerformanceManifest。
远程机器上使用时,需要暴露 7870 和实际启动的 viewer 端口。例如:
ssh -L 7870:127.0.0.1:7870 \
    -L 18590:127.0.0.1:18590 \
    -L 8765:127.0.0.1:8765 \
    -L 9876:127.0.0.1:9876 \
    user@host
产物可视化路由
inference job 完成后,Workspace 会扫描 run record 和输出目录里的可视化产物。 Artifacts 页会为支持的文件显示 Open 和 Open in ... 操作。 Job Detail 只保留内嵌 preview video/image,不再重复 viewer 快捷入口。
.png,.jpg,.jpeg,.webp,.gif,.bmp,.mp4,.mov,.webm,.mkv,.avi,.wav,.mp3,.flac,.oggmedia files — Workspace 内联预览和直接 Open 链接.ply,.pcd,.xyz,.glb,.gltf,.objgeometry files;包含可解释 geometry/depth key 的.npz— Viser Geometry Viewer.splat,.spz,.ksplat,.sog和 Gaussian-splat.ply— Spark Gaussian Splat Viewer.rrdrecordings — Rerun Timeline Viewer
Base model 感知结果
WorldFoundry 为仓内 3D 和 perception model 维护一份统一的可视化能力注册表。 编写 model-specific viewer 前先查询注册表:
worldfoundry-eval models visualizations
worldfoundry-eval models visualizations --family perception_core
worldfoundry-eval models visualizations --model raft --json
结构化 2D 结果复用同一个转换命令。当前支持 detection、mask、flow、
tracks、feature-pca、depth、normal、keypoints 和 text:
worldfoundry-eval models visualize \
  --kind flow \
  --artifact outputs/flow.npz \
  --output outputs/flow.png

worldfoundry-eval models visualize \
  --kind detection \
  --artifact outputs/detections.json \
  --media inputs/frame.png \
  --output outputs/detections.png
这条共享路径覆盖 Depth Anything、SAM、RAFT、DINO、GroundingDINO、 YOLO World、CoTracker 等仓内 family 的官方输出 schema。原生图像/视频进入 media viewer,点云和 mesh 进入 Viser,Gaussian splat 进入 Spark,同步场景记录 进入 Rerun。每个模型的权威映射以 registry 命令输出为准。
对磁盘上已有的 run,直接在 Workspace 打开该 run,用 Artifacts 标签页确认 viewer 路由。上表是路由参考;具体 run 以 Artifacts 里的 Open / Open in ... 按钮为准。
对模型作者来说,最容易复现的方式是把输出写到 Studio run 的输出目录,并在 run record 中保留稳定路径:
preview_image或preview_video:用于快速媒体预览。artifact_paths:用于原始生成产物。rrd_path:用于 Rerun recording。output_dir:用于让 Workspace 继续发现目录里的其他文件。
3D reconstruction 模型应该导出浏览器可读的 .ply、.glb、.gltf、.obj、
.pcd、.xyz 或紧凑点云/depth .npz。3DGS 模型应该导出原生 splat 文件,或者
header 中包含 scale、rotation、opacity、spherical-harmonic color 等 splat
属性的 binary little-endian Gaussian-splat PLY。Workspace 会在选择 Viser 或
Spark 前区分普通 PLY geometry 和 Gaussian-splat PLY。
坐标系契约
启动 viewer 是 geometry contract 的一部分。points、mesh、camera-to-world、frustum 和 trajectory 必须处于同一个已声明坐标系,不能只翻转点云:
- 已完成 OpenCV-to-OpenGL 对齐的官方 GLB 使用
asset-native和 exporter 声明的 up axis;VGGT/VGGT-Omega 官方 GLB 使用+Yup、alignment=none。 - VGGT/VGGT-Omega、UniDepth V2 与 UniK3D 的原始 model-point NPZ 保留 OpenCV
camera frame,Viser 只应用一次
opencv-to-opengl并使用+Yup。 - UniDepth V2/UniK3D 的 Workspace PLY 已写成
x-right/y-up/z-forward,因此使用asset-native、+Yup、alignment=none,不能再次翻转。 - DUSt3R、LoGeR 与 Pi3 的 PLY 保留预测 camera-to-world sidecar;Viser 对 points
与 cameras 一起应用
first-camera-opengl,使用+Yup,并按中心 5-95% geometry 取景,避免少量离群点把有效场景缩得过小。 - Rerun recording 必须声明 world
ViewCoordinates,并让每个Pinhole使用同一 camera convention;Cut3R 与 MonST3R 的 world/camera 都使用 RDF。
Workspace 会自动解析 VGGT、DUSt3R、LoGeR、Pi3、UniDepth V2 与 UniK3D 的上述已验证默认值。其他 exporter 可用 Visualizer Params JSON
显式覆盖。请求端口被占用时,Viser 会显示实际绑定端口。Rerun 默认使用 WebGPU;
只有目标浏览器需要时才设置 WORLDFOUNDRY_STUDIO_RERUN_RENDERER=webgl。
选择 3D viewer
默认按产物语义路由,避免每个模型重复实现 viewer:
- 静态点云、mesh、depth-derived geometry、camera frustum — 默认 viewer Viser。何时保留官方 viewer:存在共享 scene layer 无法表达的模型专用控制或标注。
- 时变 geometry、camera trajectory、同步 image/depth/action — 默认 viewer Rerun。何时保留官方 viewer:导出为
.rrd会丢失官方 timeline 语义。 - Gaussian splat — 默认 viewer Spark。何时保留官方 viewer:上游依赖非标准 shader 或 splat 格式。
viewer 进程能启动不等于 inference 已完成视觉验证。3D/4D 方法的 release evidence 应先确认 geometry 与 camera data 有限,再在真实浏览器中打开实际产物,检查 canvas 非空且构图可读,执行 reset/orbit 或 timeline 交互,并检查 console error。官方 viewer 应作为小型 visualization plugin 保留;共享 Viser/Rerun scene layer 足够时, 不要复制其 inference runtime,也不要为单个模型另写 frontend。
Studio 截图
这些截图来自当前用于模型发布验证的 7870 workspace。
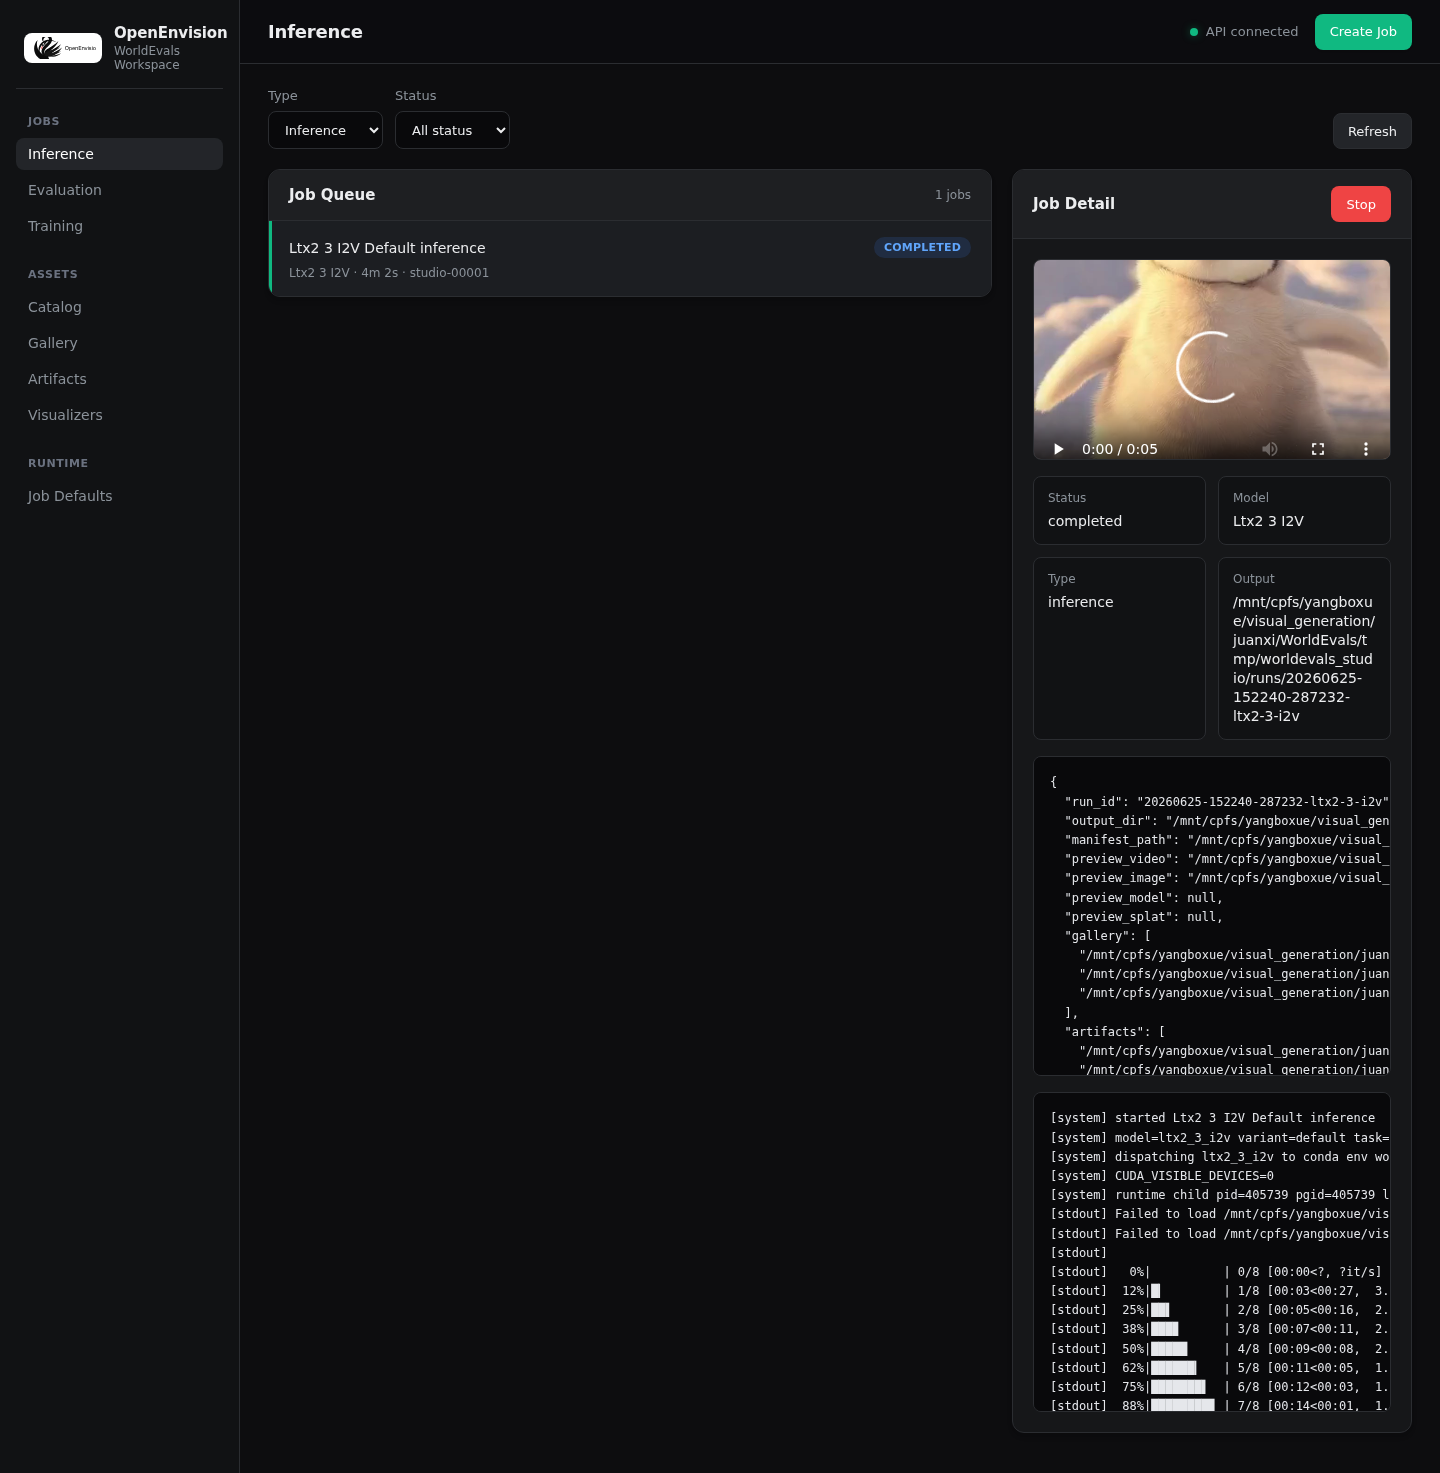
- Inference jobs — 已完成 run、内嵌 preview media、状态和日志。
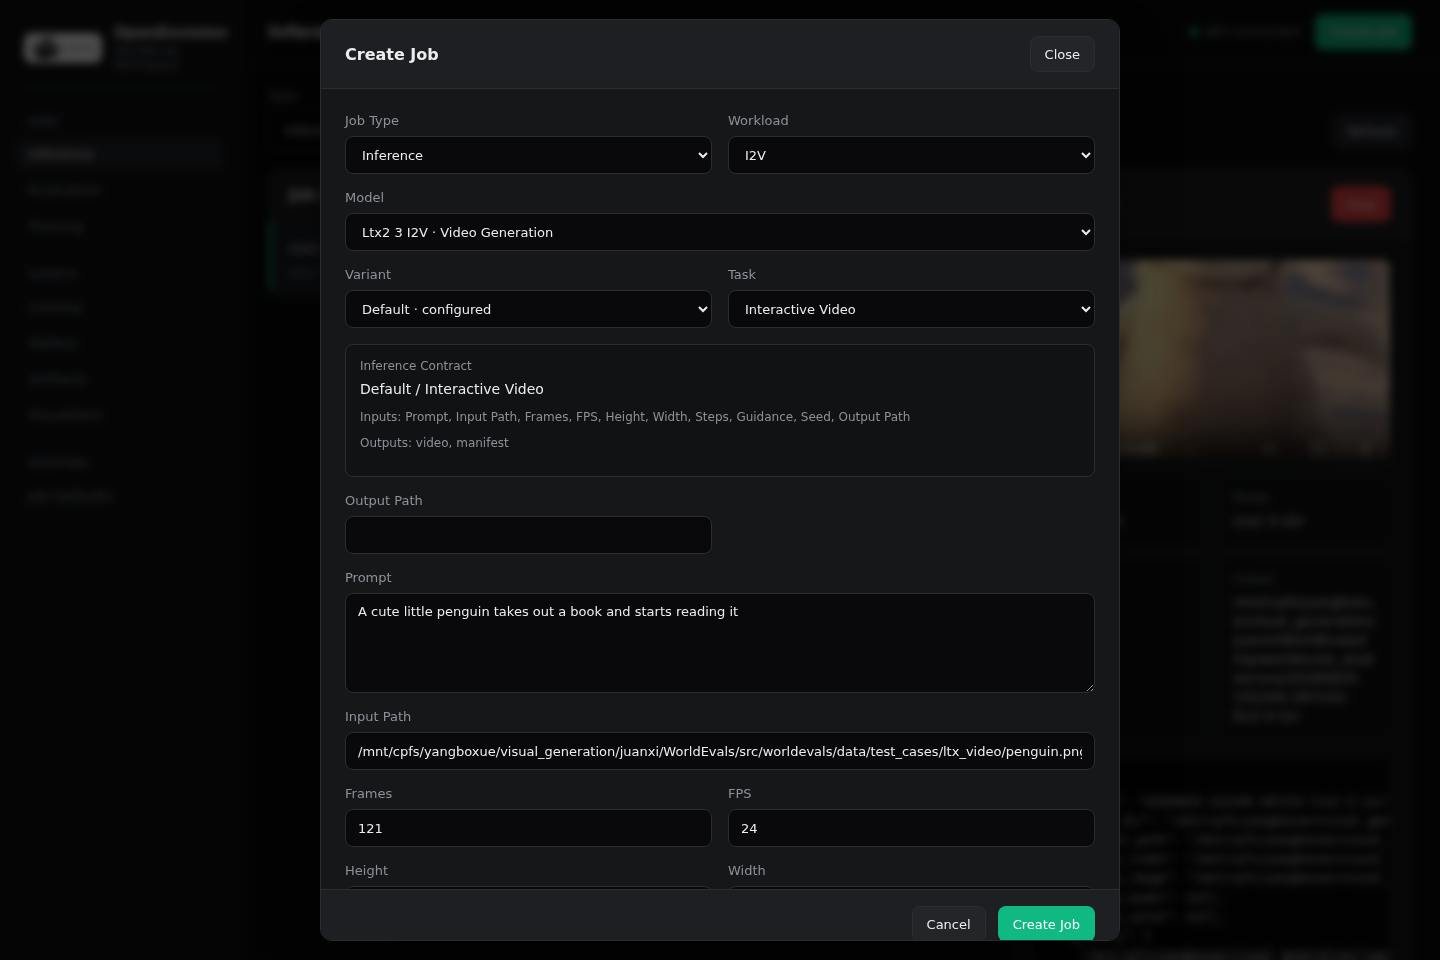
- Create Job — 模型专用输入项和官方 demo 默认值。
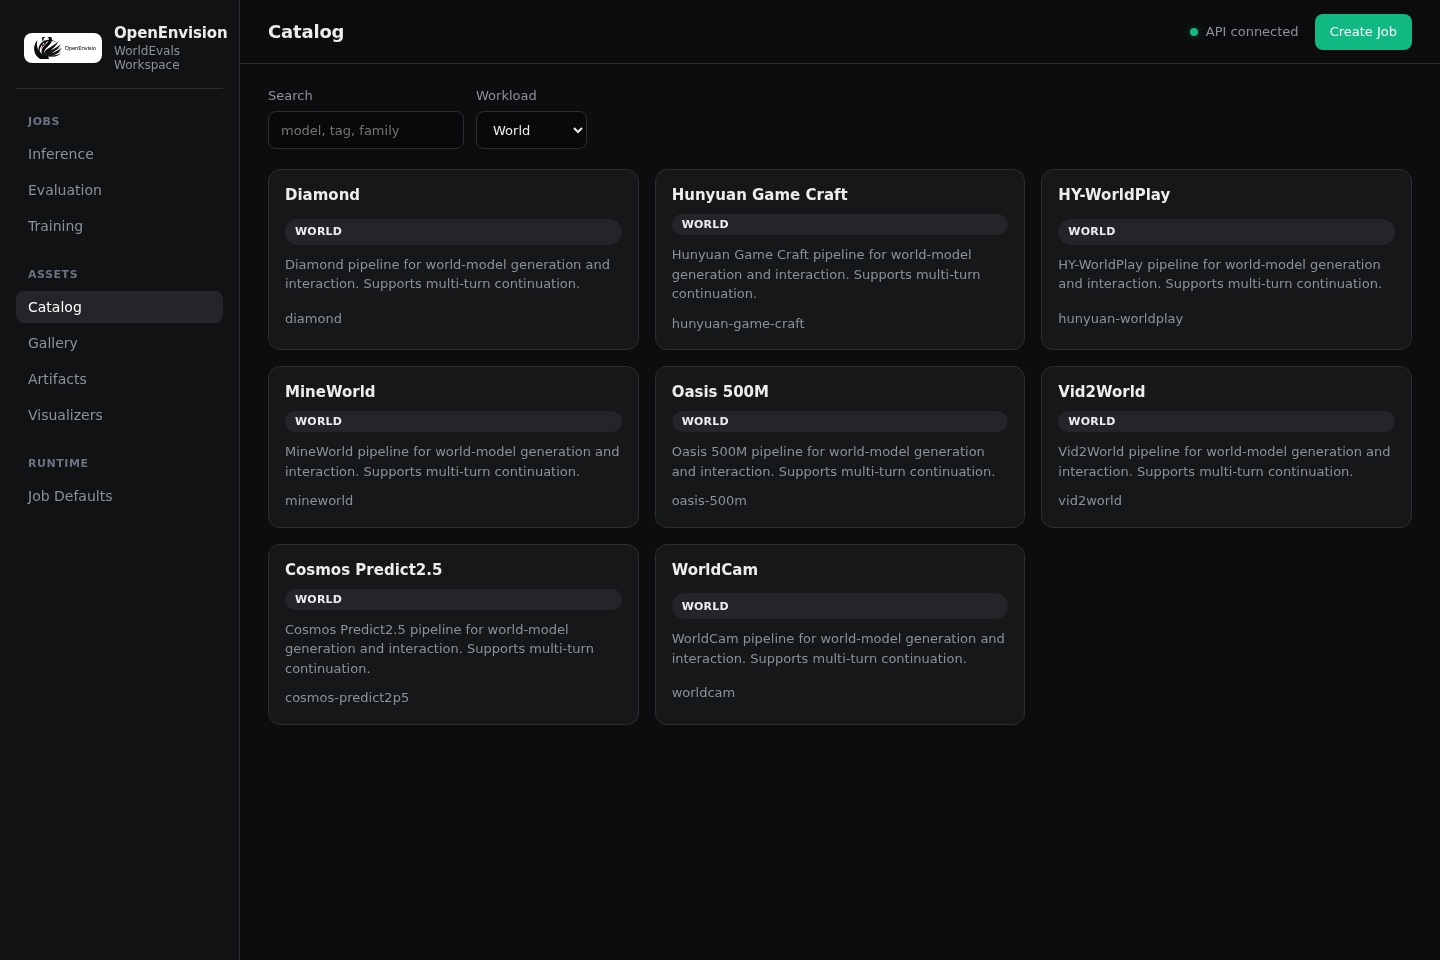
- Catalog — world-model 过滤结果和模型 metadata。
- Gallery — 最近生成结果的并排视觉检查。
Inference jobs
队列会展示已提交 run、最终状态,以及 run record 提供的内嵌 preview video 或 image。
Create Job
表单应该展示模型真实的输入 contract。 下面的截图只展示 UI 结构;真正的 release demo 声明应以发布门禁 和对应的 run manifest 为准。
Catalog
Catalog 过滤可以用来确认 workspace 提交 job 前能看到哪些 world-model entries。
Gallery
Gallery 提供最近 inference outputs 和 preview artifacts 的紧凑视觉检查入口。
启动矩阵
- LingBot realtime —
python -m worldfoundry.studio.cli lingbot-world --variant fast --frontend world --device cuda:1. 常驻 runtime、持续 WebRTC 视频和 DataChannel 控制。 - LingBot camera —
python -m worldfoundry.studio.cli lingbot-world --variant base-camera --device cuda:1. 更慢,偏 camera-centric profile。 - MatrixGame —
python -m worldfoundry.studio.cli matrix-game-2 --device cuda:1. 交互式 world navigation。 - WorldCam —
python -m worldfoundry.studio.cli worldcam --device cuda:1. Camera-path generation 和 view control。 - Hosted APIs — 在 Workspace 推理任务或
worldfoundry run <model>中配置 provider 凭据与 endpoint,再用media前端查看导出的产物。 - Viser 点云 —
python -m worldfoundry.studio.cli pi3 --frontend points --asset /path/to/scene.ply --port 18590. 原生 Viser UI。 - Spark 3DGS —
python -m worldfoundry.studio.cli vggt --frontend spark --asset /path/to/scene.splat --port 8765. 独立 Spark canvas,不进入游戏机 shell。 - Embodied simulator —
python -m worldfoundry.studio.cli openvla --frontend embodied --simulator-url http://127.0.0.1:9000. 计划中。 仅登记外部 simulator URL,不会启动仓内 viewer。
推荐本地启动:
cd /path/to/WorldFoundry
PYTHONPATH=. WORLDFOUNDRY_STUDIO_PORT=7868 conda run -p "${WORLDFOUNDRY_UNIFIED_ENV_PREFIX}" python -m worldfoundry.studio.cli \
  lingbot-world \
  --variant fast \
  --model-ref /path/to/checkpoints/lingbot-world-fast \
  --device cuda:1
如果当前 checkout 没有安装到环境里,请保留 PYTHONPATH=.。
Studio 启动时会打印解析到的 workspace、model、cache 和 Hugging Face cache 根目录,方便在真正运行前发现路径配置问题。
打开:
http://127.0.0.1:7868远程 GPU 节点推荐用 SSH tunnel。
world 进程通过配置的 HTTP 端口提供页面和 WebRTC signaling;视频与控制随后
走 ICE 选出的 WebRTC 链路。普通 SSH 端口转发只会承载 signaling,无法单独转发
WebRTC 媒体。浏览器不能直连 GPU 主机时,请通过
WORLDFOUNDRY_REALTIME_ICE_SERVERS_JSON 配置 TURN relay。
ssh -N -L 7868:127.0.0.1:7868 user@gpu-host
# local browser:
# http://127.0.0.1:7868
页面状态条会显示 RTC 播放 FPS、生成耗时、控制延迟、队列深度和丢弃的旧帧。 ICE 超时会明确报错,不会让页面永久停留在连接中。
交互模式
- Image World — 选择示例图或上传 image ->
START-> 按住键盘或摇杆控制。image-conditioned 交互世界模型。 - Video World — 上传 video ->
START-> 后续 video-to-video / continuation 流程。video-conditioned world model。 - Stream — seed input -> 启动一个持续会话 -> 按键边沿与生成帧连续流动。交互式世界模型和 continuation。
- Prompt-scheduled segments — 输入 prompt,可选一张 image,然后
START;当前 segment 完成后修改 prompt 并按Enter。在原生 segment 边界接收新 prompt 的模型。 - Queued controlled segments — 选择初始 image、dense control video、sparse control video 和 prompt ->
RUN;每次EXTEND前选择新的控制视频。每个 segment 都有显式控制输入的长时程模型。 - Spatial preview — 运行或导出 3D asset -> 从 Workspace Visualizers 打开 Spark 查看 Gaussian splat,或打开 Viser 查看点云和 mesh。
键盘/实时控制:
WASD = move
Arrow keys / IJKL = look
键盘和摇杆的按下/释放边沿会立即通过当前实时通道发送。常驻 runtime 在模型 chunk 边界采样最新的有效控制状态;输入不会创建第二个 inference request,也 不会重新加载 pipeline。
实时文本事件、Idle step 与输出分辨率
world 前端在键盘和摇杆旁边提供三组有序控制:
- 文本事件: 打开 INITIAL SCENE,选择 ADD,填入 event ID、按钮标签 与 prompt。APPLY 会在会话开始前装载事件目录,或在会话进行中替换它。事件 按钮会在下一个模型 chunk 边界激活一个文本条件;CLEAR EVENT 恢复基础 prompt。没有状态保持式文本更新路径的模型会禁用这个入口,而不是假装接受了 一次它无法应用的更新。
- STEP: 只排入一个不带键盘方向的生成 chunk,适合静止镜头或检查某个文本 事件,不会开启自动生成循环。Queued-segment 模型的 STEP 保持禁用,因为 它们的下一个 segment 需要新的控制视频。
- OUTPUT: 选择传输帧尺寸。NATIVE 保持模型输出尺寸;更小的选项只会对 WebRTC/WebSocket 流做缩放和 letterbox,不会改变模型推理分辨率、采样步数、 causal state 或后续世界质量。
Event ID 由 1–64 个字母、数字或 _.:- 组成;标签最长 64 字符,prompt 最长
1,000 字符,一个目录最多 12 个事件。目录更新带 revision,因此过期的编辑器
不会静默覆盖更新过的实时目录。
可靠控制通道会返回 event_catalog_ack、event_ack、step_ack 和
output_config_ack。事件或输出 ACK 表示这条有序请求已被接受,并说明它在哪里
生效(next_chunk 或 next_segment);生成输出的完成信号仍然是 chunk_done。
分辨率切换固定在完整 transport chunk 的边界上,因此已经声明的 chunk 不会被
截断,也不会混用不同尺寸。每条请求与 ACK 携带相同的 request_id,所以快速
连点不会让旧响应覆盖当前 UI 状态。
不使用内置控件时,同一套协议也可以直接驱动:
{"type":"event_catalog","request_id":"catalog-1","base_revision":0,"events":[{"event_id":"rain","label":"Rain","prompt":"Heavy rain begins.","category":"weather"}]}
{"type":"event","request_id":"event-1","event_id":"rain","state":"trigger"}
{"type":"event","request_id":"event-2","state":"clear"}
{"type":"action","request_id":"step-1","action":{"event":"step"}}
{"type":"output_config","request_id":"output-1","resolution":{"mode":"fixed","width":640,"height":360}}
固定传输尺寸必须是偶数,不小于 160x90,两个方向都不超过模型的原生/生成帧
尺寸,并且在实时 1920x1080 像素预算之内。Studio 只提供由 model catalog 推导
出的、对源安全的预设;原生尺寸未知时它不会猜测某个固定预设。切回
{"mode":"native"} 会移除传输层缩放。WebRTC 的缩放工作在帧进入 media track
之前完成,因此被保留的帧不会反复付出缩放代价,也不会阻塞控制事件循环。
可拖拽与可折叠面板
STATUS、CONTROLS、INITIAL SCENE 与 RUNTIME 共用同一套面板行为。
拖动面板标题栏可以让它浮在 viewport 上方,点 − 折叠,点 + 重新展开。
浏览器会把浮动面板限制在可见舞台内、把选中的面板置顶,并在本地保存位置与
折叠状态。拖动每个浏览器帧只做一次 animation-frame transform,不会给模型/帧
传输路径增加负担。在窄屏移动端布局中,面板保持在文档流内,但仍可折叠。
沉浸式全屏与实时运行日志
全屏视图属于共享的 world 前端,因此所有路由到该前端的交互模型都可以使用。
它会复用当前 peer 或 socket、帧缓冲和常驻模型会话。进入或退出全屏不会让
浏览器重连,也不会重启生成。
- 按正常流程准备模型输入并启动会话。
- 点击 viewport 左上角的 FULLSCREEN,或按
F。 - 画面会铺满屏幕,并自动打开实时运行日志。
- 点击 LIVE LOG 或按
Shift+L,可以在不退出全屏的情况下隐藏或显示日志。 - 按
Esc或点击 EXIT,返回标准 Studio 布局和同一个活动会话。
- FULLSCREEN /
F— 进入或退出沉浸式全屏。 - LIVE LOG /
Shift+L— 在普通布局或全屏布局中开关运行日志。单独按L仍然是视角向右控制。 - CLEAR — 只清空页面上可见的日志历史;不会重置模型会话或 runtime 状态。
Esc— 退出全屏,回到同一个活动会话。
日志会展示 client/model 就绪状态、实时传输状态、segment 排队/生成/播放阶段、
错误和每个 chunk 的性能数据。chunk 完成后会记录帧数、生成耗时 (gen)、播放
队列深度 (queue) 和丢弃的旧帧数 (dropped)。这些内容用于当前交互会话排障;
它们不是持久化 run artifact,也不是服务端完整 stdout/stderr 的副本。
实时日志复用现有实时连接。浏览器按 animation frame 批量更新 DOM,并且最多 保留最近 120 条记录,因此长时间游玩不会无限扩大日志树,也不会在帧传输热路径 增加轮询。浏览器允许 Fullscreen API 时,点击按钮或使用快捷键会进入原生全屏; 如果原生全屏不可用或被浏览器策略阻止,Studio 会保持当前会话,并回退到铺满 浏览器视口的布局。 Workspace 的 visualizer iframe 已经授予 fullscreen 权限。
启动 flags
参数
positional model_id--model启动目标。
--variantRuntime profile,例如
fast或base-camera。--model-ref--ckpt--checkpoint显式 local 或 repo reference。
--deviceRuntime device。
--backendauto、from_pretrained或api_init。--endpoint显式 API endpoint。
--frontendauto、world、points、spark、embodied、media或rerun。也接受viser、3dgs等别名。--asset原生 viewer 的远端资产路径,例如 point cloud
.ply/.npz或 3DGS.splat/.spz/.ply。--simulator-url具身仿真器原生 URL。
--host--port覆盖前端监听地址和端口。
环境变量
环境变量
WORLDFOUNDRY_WORKSPACE_PORTWorkspace HTTP 端口(默认
7870)。WORLDFOUNDRY_WORKSPACE_HOSTWorkspace 监听地址(默认
127.0.0.1)。WORLDFOUNDRY_STUDIO_AUTH_TOKEN绑定非 loopback 地址时必填。客户端发送
Authorization: Bearer <token>或?token=。Loopback 仍不鉴权。WORLDFOUNDRY_STUDIO_WORKSPACE_URLMCP Studio 工具使用的 Workspace 基址(默认
http://127.0.0.1:7870)。WORLDFOUNDRY_WORKSPACE_MAX_JOBS并发 job worker 上限。
WORLDFOUNDRY_STUDIO_SETTINGS_FILE可选 JSON 文件,启动时加载到
/api/settings,供 Create Job 默认值使用。WORLDFOUNDRY_STUDIO_PORT单模型 Studio server 端口。
WORLDFOUNDRY_STUDIO_MODELDefault model ID。
WORLDFOUNDRY_STUDIO_VARIANTDefault variant。
WORLDFOUNDRY_STUDIO_BACKENDDefault backend。
WORLDFOUNDRY_STUDIO_DEVICEDefault device。
WORLDFOUNDRY_STUDIO_ENDPOINTAPI endpoint。
WORLDFOUNDRY_STUDIO_FIXED_MODEL_REF固定 local model/checkpoint ref。
WORLDFOUNDRY_STUDIO_FRONTEND默认 frontend 路由。
WORLDFOUNDRY_STUDIO_ASSET原生 viewer 默认资产。
WORLDFOUNDRY_STUDIO_SIMULATOR_URL具身 simulator URL。
WORLDFOUNDRY_STUDIO_SPARK_PORTSpark 前端默认端口。
WORLDFOUNDRY_STUDIO_POINTS_PORTPoints 前端默认端口。
WORLDFOUNDRY_STUDIO_SSH_HOST启动日志中 tunnel 命令使用的 SSH host;设置为用户自己的 GPU 节点,例如
user@gpu-host。WORLDFOUNDRY_STUDIO_WORKSPACE_DIRStudio run/output 根目录;未设置时优先使用
${WORLDFOUNDRY_ARTIFACT_DIR}/studio,否则使用tmp/worldfoundry_studio。WORLDFOUNDRY_STUDIO_MODEL_ROOT额外 local model repo 根目录,会在共享 roots 前优先搜索。
WORLDFOUNDRY_MODEL_DIR共享 model/checkpoint 根目录;Studio 会搜索其中的本地 repos 和 checkpoints。
WORLDFOUNDRY_CACHE_DIR共享 cache 根目录;Studio 会搜索
${WORLDFOUNDRY_CACHE_DIR}/hfd和${WORLDFOUNDRY_CACHE_DIR}/repos。WORLDFOUNDRY_HF_CACHE_DIR可选 Hugging Face Hub cache 覆盖。默认不设置,交给 Hugging Face 原生
from_pretrained/snapshot_download缓存与自动下载策略处理。
Studio 只支持 WORLDFOUNDRY_* 环境变量。
发布证据
只有当对应官方配置已经通过仓内 Studio 或 Studio-compatible API 路径运行后, 才把 demo media 放到公开文档中。保留对应 run manifest、解码后的视频元数据和 视觉 QA 记录,确保页面中嵌入的视频可以追溯到实际 release candidate run。
代码组织
Studio 的实现各自只有一个 canonical import path,根目录仅保留 CLI 与 worker 入口。
| 路径 | 职责 |
|---|---|
inference/catalog.py | pipeline 发现、模型默认参数与 checkpoint 解析 |
inference/config.py | 运行环境与分布式进程拓扑 |
inference/execution.py | 输入准备、模型加载、执行与原始 artifact 保存 |
inference/dispatch.py | GPU admission、受管子进程、resident worker、取消与 deadline |
inference/paths.py、inference/variants.py | 运行路径和模型变体选择 |
serving/workspace.py、serving/jobs.py | Workspace API 与 UI 任务调度 |
serving/ | 认证、文件服务、遥测和 realtime transport |
ui/ | 浏览器启动选项、模型接口、共享浏览器资源与 Workspace 页面 |
ui/workspace.html、ui/workspace.py | 打包的 Workspace 页面和资源加载器 |
visualization/ | artifact 发现、viewer 路由与 geometry 展示 |
cli.py、runtime_job.py、workspace_job.py | 安装命令与子进程入口 |
推理模块不导入 UI、serving 或 visualization。StudioManager 默认保存原始 artifact;需要预览的前端显式安装 visualization.studio.prepare_run_record 为 record_processor。原 studio/native 的 CUDA/C++/ImGui 前端已删除。
visualization/plugins 保留实际调用的实现:perception/render.py 用于 CLI 和 Grounding DINO;perception/human_pose.py 生成 Wan Animate conditioning;scene3d/projection.py 服务 VIPE;scene3d/depth_anything_v3/export_vis.py 服务 DA3 导出;styles/colormaps.py 提供 depth / normal 着色。未使用的 media、robotics、pixelSplat training 可视化、重复 DVLT、HED 和 sky-segmentation/GLB 链已删除。
worldfoundry/representations 已删除。Depth Anything、VGGT、Pi3、WorldFM、Lyra 等几何 pipeline 直接从 worldfoundry/base_models/three_dimensions 对应模型目录导入 runtime;checkpoint 加载、预处理与几何后处理和模型代码放在一起。空基类、marker class 和旧路径转发模块不再保留。Artifact 展示仍由 Studio visualization 负责。
推理生命周期
受管 CUDA 推理在启动前获取设备租约。显式设备选择和 one-shot fallback 使用同一 admission 策略,resident worker 在所属进程组停止前持续持有租约。Linux 文件锁协调同一主机上的 WorldFoundry 控制器;WORLDFOUNDRY_GPU_LEASE_DIR 指定共享锁目录,默认 /tmp/worldfoundry-gpu-leases-<uid>。共享 GPU 的控制器应使用相同目录和物理设备标识;未受管 workload 不在此协调范围内。
WORLDFOUNDRY_STUDIO_INFERENCE_TIMEOUT 为 GPU 排队、worker 分配、请求排队、执行和输出 draining 提供一个 deadline,默认继承 resident timeout(未设置时六小时),0 关闭。取消和失败先清理所属进程组,再释放租约。主动创建其他 session 的进程不在进程组所有权约定内;托管 API 使用 provider 的 timeout / cancellation。
权重 pipeline 可缓存;API client 按请求创建,避免保留其他请求的凭据。持久命令任务使用独立 supervisor 和原子 completion receipt,控制器退出后仍能恢复真实状态。恢复后的进程必须通过 boot、start、session 和 group 身份核对才能接受信号,终态任务清理同时删除其 receipt。
默认 python -m pytest 运行公开 CPU 门禁;UI 和 renderer 回归位于 tests/studio 与 tests/studio_visualization,需要相应依赖。默认门禁不使用真实权重或 API 凭据。