PAWBench
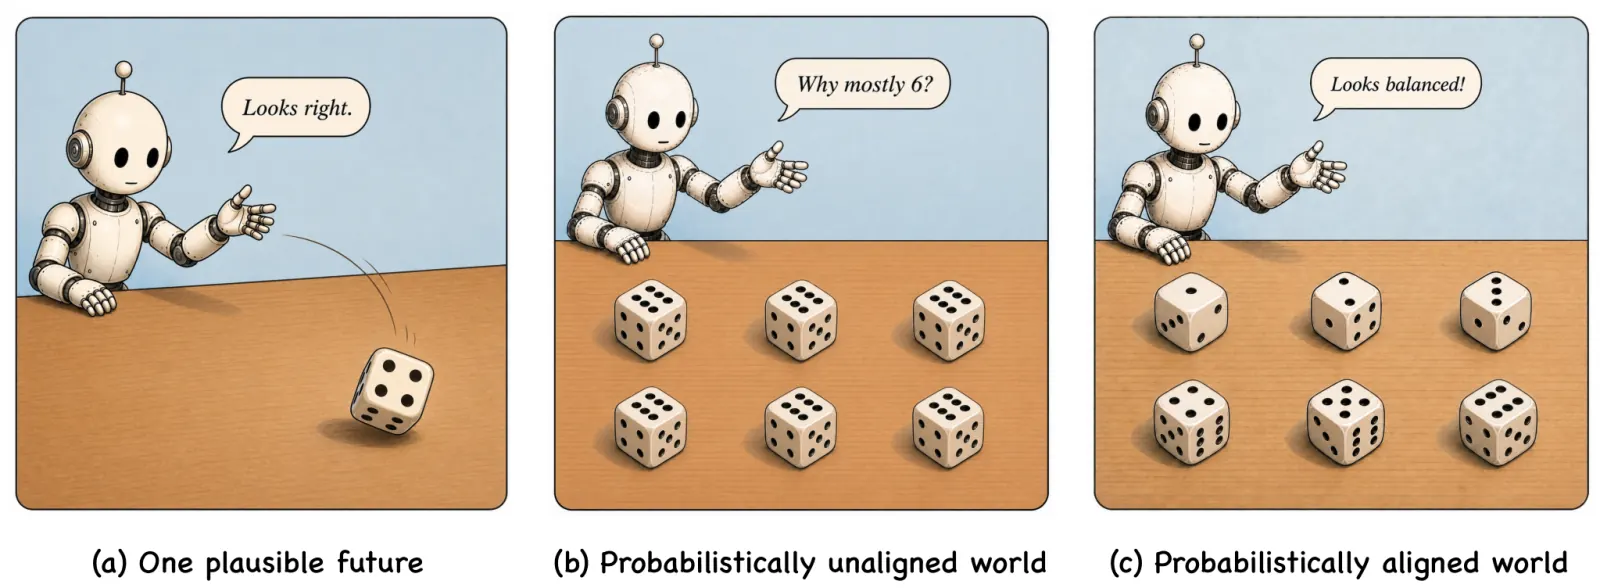
PAWBench(上海交大、上海 AI Lab、Krea AI、Hugging Face、上海创智学院、通义实验室、港大)问的是重复生成能否恢复物理上有效未来的 分布,不是单条视频好不好看。官方规模:50 个场景(25 个带参考结果概率的校准场景,25 个覆盖场景)。完整运行每个场景生成 50 条独立 rollout,共 2,500 条视频。
两条赛道分开报。上游 没有定义合并标量。
- 校准 —
calibration_tvd_percent(越低越好):与参考结果分布的总变差距离。 - 覆盖 —
coverage_percent:在重复 rollout 中观察到的官方物理结果支撑比例。
论文:PAWBench。项目:pawbench.github.io。代码:Andrew0613/PAWBench(Apache-2.0)。数据:Andrew613/PAWBench。
WorldFoundry 仓内内置官方 PAWEval judge。新打分默认走 OpenRouter 上的 Gemini 3.5 Flash;其他 OpenAI 兼容 judge 仅供分析。已有 metrics.json 或运行目录可离线导入。
评测维度
- PAW 校准类型赛道
25 个带参考结果概率的场景。指标:calibration_tvd_percent(越低越好)。
- PAW 覆盖类型赛道
25 个覆盖场景。指标:coverage_percent。
数据组成
- 规模
50 个场景(25 校准 + 25 覆盖)。官方运行:每场景 50 条独立 rollout,共 2500 条视频。没有官方合并标量。Apache-2.0。
- 来源
Andrew613/PAWBench · github.com
- 模态
image · video · text
- 许可证
Apache-2.0
- 说明
WorldFoundry 内置 PAWEval(默认 OpenRouter 上的 Gemini 3.5 Flash)。不完整覆盖是 blocker,不会静默平均。
指标
指标
- 方向越低越好
calibration_tvd_percent生成结果分布与参考分布之间的总变差距离。
- 方向越高越好
coverage_percent重复 rollout 覆盖官方物理结果 support 的比例。
Leaderboard
论文报告结果(非实时榜;不是 WorldFoundry 跑分)。 论文校准 TVD。覆盖率另行报告。 PAWBench: How Far Are We from Probabilistically Aligned World Modeling? (2026).
| 模型 | PAW-Calibration TVD ×100(越低越好) |
|---|---|
| Cosmos 3 Super I2V | 20.5 |
| MiniMax H3 | 24.2 |
| Wan2.7 | 26.3 |
| Wan2.2 | 26.3 |
| LTX-2.3 | 30.1 |
| LTX-2.5 | 30.2 |
| Seedance 2 | 30.5 |
| Kling 3 Std. | 34.9 |
如何运行
hf download Andrew613/PAWBench --repo-type dataset --local-dir /data/pawbench
export OPENROUTER_API_KEY=<your-key>

worldfoundry-eval zoo benchmark-run \
  --benchmark-id pawbench \
  --mode official-run \
  --benchmark-data-root /data/pawbench \
  --generated-artifact-dir /data/my-model-rollouts \
  --output-dir tmp/pawbench/official-run \
  --json
导入已有运行:
worldfoundry-eval zoo benchmark-run \
  --benchmark-id pawbench \
  --mode official-validation \
  --official-results-path /path/to/pawbench/run \
  --output-dir tmp/pawbench/imported \
  --json
产物包括 scorecard.json、raw_metric_table.jsonl、per_sample_scores.jsonl、benchmark_contract.json。仓内样本只是归一化 fixture。
Rollout、裁判与 metrics.json
流程:benchmark 包 → 你的视频生成器 → rollout 目录 → PAWEval → metrics.json。生成器与裁判是不同模型。官方 runner 不加载视频模型,只打磁盘上已有的视频。额外 pip:worldfoundry/data/benchmarks/requirements/pawbench.txt。
HF 下载包含场景表、源图、生成 prompt 与打分策略(100 条可审阅 rubric:每个场景一条结果 rubric + 一条可信度 rubric)。把完整 50 × 50 网格写成:
my-model-rollouts/
  <scene-id>/
    r000.mp4
    …
    r049.mp4
官方 PAWEval 用 OpenRouter 上的 Gemini 3.5 Flash(OPENROUTER_API_KEY)。这条路径不需要 OPENAI_API_KEY。其他 OpenAI 兼容裁判(--vlm-base-url、--vlm-model、--vlm-api-key-env)只供分析,不能和官方表直接比。
--model-name 是写进结果文件的标签,不加载权重。同一 benchmark、模型名、视频和裁判配置再跑会接着已完成的 rollout 判断。
PAWEval 在运行目录写下 run.json、checkpoint.jsonl、rows.jsonl、metrics.json。完整运行是 status: "ok" 且没有 blocker。两条赛道均值分开:
- 校准 TVD:
tracks.calibration.models.<model>.track_average(越低越好)。 - 覆盖:
tracks.coverage.models.<model>.track_average(越高越好)。
status 为 "blocked" 时,先修列出的缺视频 / 裁判 / 基础设施错误再报分。可信度 rubric 记录动作、连续性、过程失败,不改终点标签。
单条 rollout 只是读出,不是模型分。例如 50 次抛硬币的正反面频率,用 TVD 对照场景参考分布。