STEVO-Bench
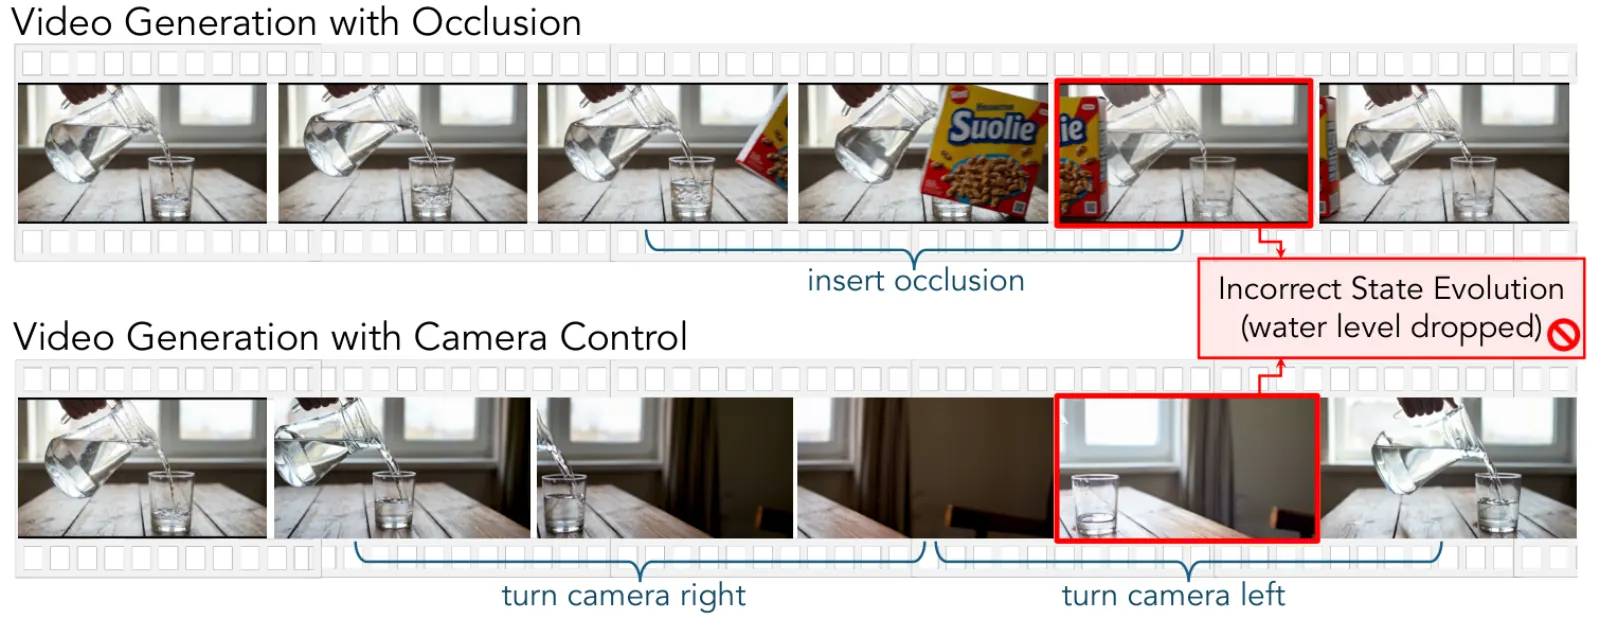
STEVO-Bench(Caltech GLab)问的是视频世界模型在 观察被切断时是否仍在模拟状态演化。每个任务施加一种观察控制(场内遮挡、相机转开、或光照变暗)再加一个触发动作。VLM 裁判检查隐藏过程是否继续推进且物理上合理。官方规模:6 类世界变化、225 个任务。许可证:MIT(仓内 runtime 保留,钉选 680fb6ee2733…)。
三个可执行判据(钉选 eval/eval_cli.py):control(occlusion_done、trigger_applied)、physics(physical_inaccuracy)、state(state_evol)。钉选 CLI 没有 --artifact / --coherence。聚合对齐 eval/summarize_results.py:control_success = occlusion_done AND trigger_applied,task_success = state_evol AND NOT physical_inaccuracy(主键)。
论文:STEVO-Bench。站点:glab-caltech.github.io/STEVOBench。任务:JhanLiufu/StEvo-Bench。上游:jhanliufu-personal/STEVO-Bench。
WorldFoundry 仓内内置官方裁判代码。裁判是远程 VLM API(默认 Gemini;GOOGLE_API_KEY)。论文配置:--ensemble-size 3。--run-fixture 只是合成归一化样本。
worldfoundry/data/benchmarks/assets/stevo-bench/sample_run/ 对齐钉选评测器写出的布局(eval/eval_cli.py 加 eval/summarize_results.py):summary.json 以及 per_task/<task_id>/se_report__<provider>__<model>.json。里面没有上游任务、prompt、视频或真实裁判输出。真正的 225 题在 JhanLiufu/StEvo-Bench;真实裁决来自 --run-official 时的托管 VLM API。per_task/candle_burn_01/ 故意带一条 summary.json 里没有的裁决,用来覆盖 report-merge 路径。
评测维度
- 控制类型赛道
occlusion_done 与 trigger_applied。control_success 为二者同时成立。
- 物理类型赛道
physical_inaccuracy;越低越好。
- 状态演化类型赛道
state_evol:隐藏过程继续推进。主键 task_success = state_evol AND NOT physical_inaccuracy。
数据组成
- 规模
Caltech GLab 画外状态演化评测。6 类世界变化、225 个任务。官方裁判是远程 VLM(默认 Gemini,ensemble 3)。MIT。
- 来源
JhanLiufu/StEvo-Bench · github.com
- 模态
image · video · text
- 许可证
MIT
- 说明
WorldFoundry 内置官方评测器(钉选 680fb6ee2733…)。在用官方 ensemble 评完 225 个任务前 leaderboard_valid 为 false。没有离线裁判。
指标
指标
- 方向越高越好
task_success状态演化被确认且无物理不合理;<strong>主指标</strong>。
主指标Task Success
- 方向越高越好
state_evol_success隐藏过程在不可见期间持续推进。
- 方向越低越好
physical_inaccuracy物理 judge 标记出不合理伪影的比例;normalized score 为 <code>1 - rate</code>。
- 方向越高越好
occlusion_done请求的观察控制确实出现在生成视频中。
- 方向越高越好
trigger_applied请求的触发动作确实被施加。
- 方向越高越好
control_success两种控制都被施加。
Leaderboard
论文报告结果(非实时榜;不是 WorldFoundry 跑分)。 论文视频模型 Success 列。 Out of Sight, Out of Mind? Evaluating State Evolution in Video World Models (2026).
| 模型 | 成功率 |
|---|---|
| Veo 3 | 8.7 |
| Sora 2 Pro | 8.1 |
| WAN 2.2 | 0.9 |
| HY-Video 1.5 | 0.9 |
| CogVideoX 1.5 | 0.5 |
如何运行
hf download JhanLiufu/StEvo-Bench --repo-type dataset --local-dir /path/to/stevo-bench-tasks
export WORLDFOUNDRY_STEVO_BENCH_TASK_ROOT=/path/to/stevo-bench-tasks
export WORLDFOUNDRY_STEVO_BENCH_VLM_PROVIDER=gemini
export GOOGLE_API_KEY=<your-key>

${WORLDFOUNDRY_UNIFIED_PYTHON} \
  worldfoundry/evaluation/tasks/execution/runners/stevo_bench/run_stevo_bench_official_runner.py \
  --run-official \
  --generated-artifact-dir /path/to/generated \
  --task-root "${WORLDFOUNDRY_STEVO_BENCH_TASK_ROOT}" \
  --criterion all \
  --ensemble-size 3 \
  --workers 5 \
  --summarize \
  --output-dir tmp/stevo_bench/official-run \
  --json
导入 summary.json、运行目录、runs/ 父目录或裸 per_task/ 树时不需要 API key:
worldfoundry-eval zoo benchmark-run \
  --benchmark-id stevo-bench \
  --mode official-validation \
  --official-results-path /path/to/runs/<output_map_stem> \
  --output-dir tmp/stevo_bench/imported \
  --json
文件名有歧义时传 --output-map。由文件名推导的映射、小于 3 的 ensemble、部分覆盖都会记为可比性 blocker。
生成视频应放在同一目录:<task_id>.mp4,外加恰好一份 output_map.json,把每个任务 YAML 的 id 映射到相对该目录的文件名。额外 Python 依赖(裁判 API、OpenCV)在 worldfoundry/data/benchmarks/requirements/stevo-bench.txt;跨模型 ensemble 额外依赖在 worldfoundry/data/benchmarks/requirements/stevo-bench-eval-se.txt。
仓内指针:worldfoundry/data/benchmarks/tasks/external/stevo-bench.yaml,worldfoundry/evaluation/tasks/execution/runners/stevo_bench/runtime/stevo_bench。
产物包括带 leaderboard_blockers / comparability_blockers 的 scorecard.json(主键 task_success)。
生成布局与官方运行树
outputs/my_model_my_run/
  task_id_1.mp4
  task_id_2.mp4
  …
  output_map.json          ← 恰好一份 JSON
{
"task_id_1": "task_id_1.mp4",
"task_id_2": "task_id_2.mp4"
}任务 id 必须等于 --task-root 下任务 YAML 的 id。官方 runner 调用仓内 eval.eval_cli(论文 ensemble --ensemble-size 3,多数票)。不要再用已删除的 vendor shell(run_eval.sh)或旧的 --artifact / --coherence——钉选 CLI 上没有这些开关。
跑完后的官方目录:
runs/<output_map_stem>/
  summary.json
  per_task/<task_id>/
    control_report.json
    物理报告(physical_inaccuracy)
    se_report.json
--summarize 按 eval.summarize_results 的方式刷新 summary.json。--official-results-path 可以指向该运行目录、父级 runs/、summary.json,或裸 per_task/ 树。
仓内还有可选的 生成 辅助(generation.run_world_models),写出 outputs/{model}_{run_name}/ 和 output map。模型在 generation/configs/models.yaml 注册:type: api(Veo / Sora 适配器、prompt_field、api_key_env、RPM / 超时)或 type: local(run_single.sh,参数 --prompt、--output,可选 --init_frame / --camera_control;大模型可加 daemon_script + --tasks_json)。WorldFoundry 生成仍走已集成模型;那只是可选的 vendor 工具。
可选的 eval_se 研究脚本
runtime/stevo_bench/eval/eval_se/ 是另一套 Gemini 两步探测(用首帧 + 动作预测隐藏过程,再核验视频)。不是官方三条判据 CLI。
- 标准 / evidence / ensemble prompt(
gemini_evaluator.py、gemini_evaluator_evidence.py、gemini_evaluator_ensemble.py)。他们的测试里 evidence 是最好的单裁判;--ensemble每题 3 次调用(大约 3 倍费用)。 - Gemini+GPT 一致通过:
gemini_gpt_evaluator.py(依赖worldfoundry/data/benchmarks/requirements/stevo-bench-eval-se.txt)。 - 这些脚本默认过滤:level-4、id 不以
_00结尾,且首帧图 + 视频 + YAML 都在。
只用于分析。可报告的 WorldFoundry 分数来自 run_stevo_bench_official_runner.py / worldfoundry-eval zoo benchmark-run --benchmark-id stevo-bench。