PhysVidBench
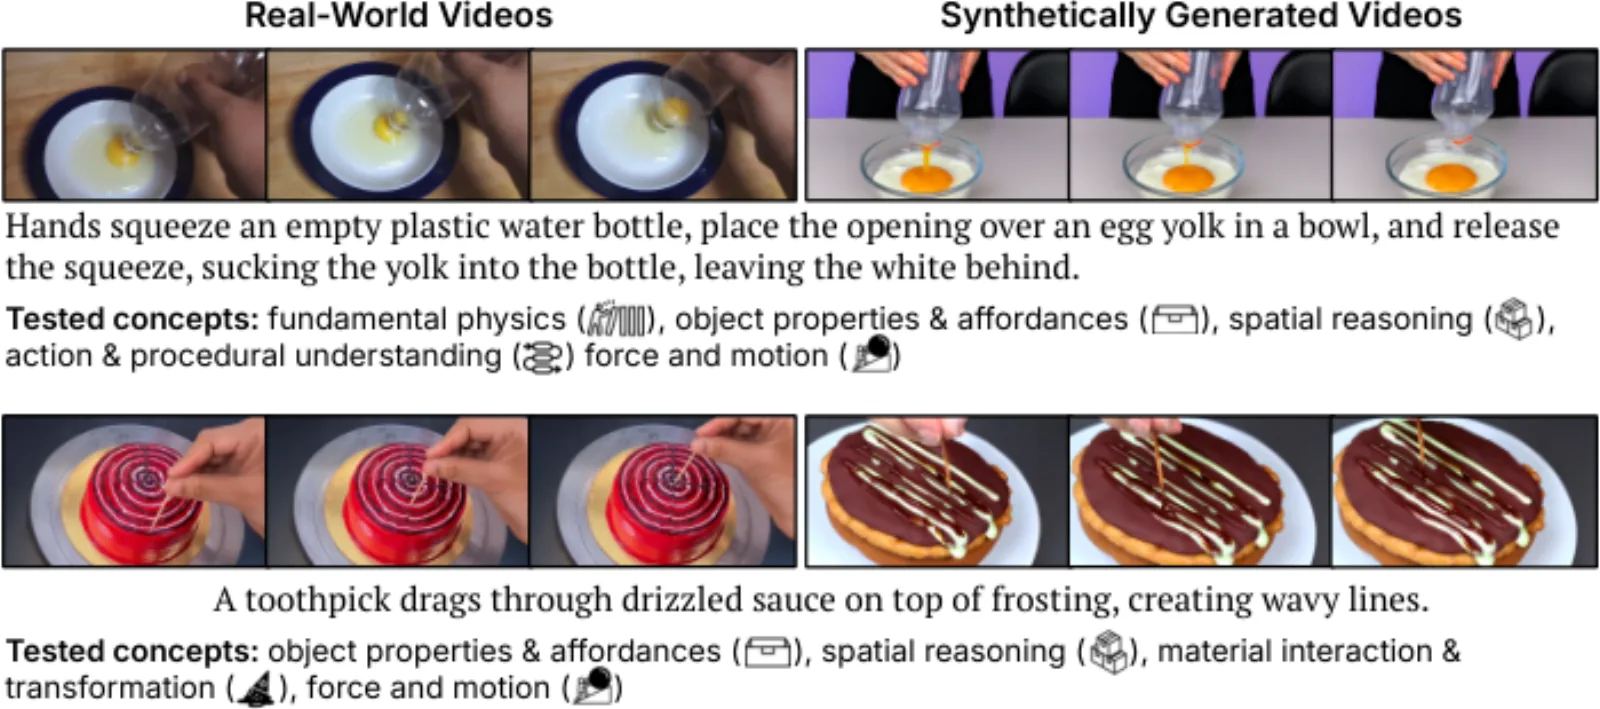
PhysVidBench(Koç University / Cyberiada)是字幕中介 QA,不是像素对齐,也不是 PhyGenEval。T2V 模型先生成视频;上游 AuroraCap 出字幕;LLM 针对字幕回答物理是/否(可供性、工具使用、材料、时序动力学)。目录记录 383 条 prompt 与 4123 道问题(cc-by-4.0)。
PhyGenBench 用 VQAScore/VLM 阶段直接评视频。PhyGround 套 1–5 定律准则。PhysVidBench 在仓内不看像素——只看字幕 + 问题。
论文:PhysVidBench。项目:cyberiada.github.io/PhysVidBench。代码:ensanli/PhysVidBenchCode。数据:Anonymousny/PhysVidBench。
WorldFoundry 捆绑 prompts_questions.csv 与字幕轨道。它导入上游 output.csv,或对你提供的字幕跑有界 Gemini QA。它不对你的视频跑 AuroraCap,也无法证明这些字幕来自那些视频。
评测维度
- 字幕中介 QA类型任务
生成视频先出字幕(上游 AuroraCap);LLM 针对字幕回答物理是/否问题——不是相对真实未来的像素 IoU。
- 可供性类型类别
交互与可供性(affordance)问题。
- 工具使用类型类别
工具中介的物理交互一致性。
- 材料类型类别
材料属性一致性问题。
- 时序动力学类型类别
物理时序动力学问题。
数据组成
- 规模
目录记录 383 条 prompt 与 4123 道问题(cc-by-4.0)。WorldFoundry 捆绑 prompts_questions.csv 与字幕轨道;导入 output.csv,或对所供字幕跑有界 Gemini QA。从你的视频生成 AuroraCap 字幕不在仓内。
- 来源
Anonymousny/PhysVidBench · github.com
- 模态
text · video
- 许可证
cc-by-4.0
- 说明
对所供字幕的 Gemini QA 不是官方全流水线证据。只有导入上游全流水线 output.csv 才具官方效力。
指标
指标
- 方向越高越好
physical_commonsense_accuracy针对字幕的物理是/否 QA 总体准确率。
- 方向越高越好
affordance_understanding可供性与交互问题族。
- 方向越高越好
tool_use_consistency工具中介交互问题族。
- 方向越高越好
material_property_consistency材料属性问题族。
- 方向越高越好
temporal_dynamics_consistency物理时序动力学问题族。
- 方向越高越好
physvidbench_average可用 QA 得分族的均值。
主指标PhysVidBench Average
Leaderboard
论文报告结果(非实时榜;不是 WorldFoundry 跑分)。 论文 Average 列(主分数,不含括号内差值)。 PhysVidBench: Language-Grounded Evaluation of Physical Commonsense in Text-to-Video Models (2025).
| 模型 | 平均分 |
|---|---|
| Wan2.1 (14B) | 34.1 |
| MAGI-1 | 32.6 |
| Wan2.1 (1.3B) | 30.6 |
| HunyuanVideo | 30.0 |
| CogVideoX (2B) | 25.6 |
| VideoCrafter2 | 22.1 |
| LTX-Video | 21.0 |
| CogVideoX (5B) | 21.0 |
如何运行
导入上游 QA 导出:
worldfoundry-eval zoo benchmark-run \
  --benchmark-id physvidbench \
  --mode official-validation \
  --official-results-path <output.csv> \
  --generated-artifact-dir <generated_videos> \
  --output-dir tmp/physvidbench/official-validation \
  --json
对所供(或捆绑)字幕跑有界 Gemini QA——不是官方全流水线证据:
${WORLDFOUNDRY_UNIFIED_PYTHON} \
  worldfoundry/evaluation/tasks/execution/runners/physvidbench/run_physvidbench_official_runner.py \
  --run-official \
  --generated-artifact-dir "${WORLDFOUNDRY_GENERATED_ARTIFACT_DIR}" \
  --captions-dir worldfoundry/data/benchmarks/assets/physvidbench/captions \
  --output-dir tmp/physvidbench/official \
  --json
用 WORLDFOUNDRY_PHYSVIDBENCH_JUDGE_BACKEND 选择 judge。产物包括 scorecard.json(主键 physvidbench_average)与 output.csv。