T2V-CompBench
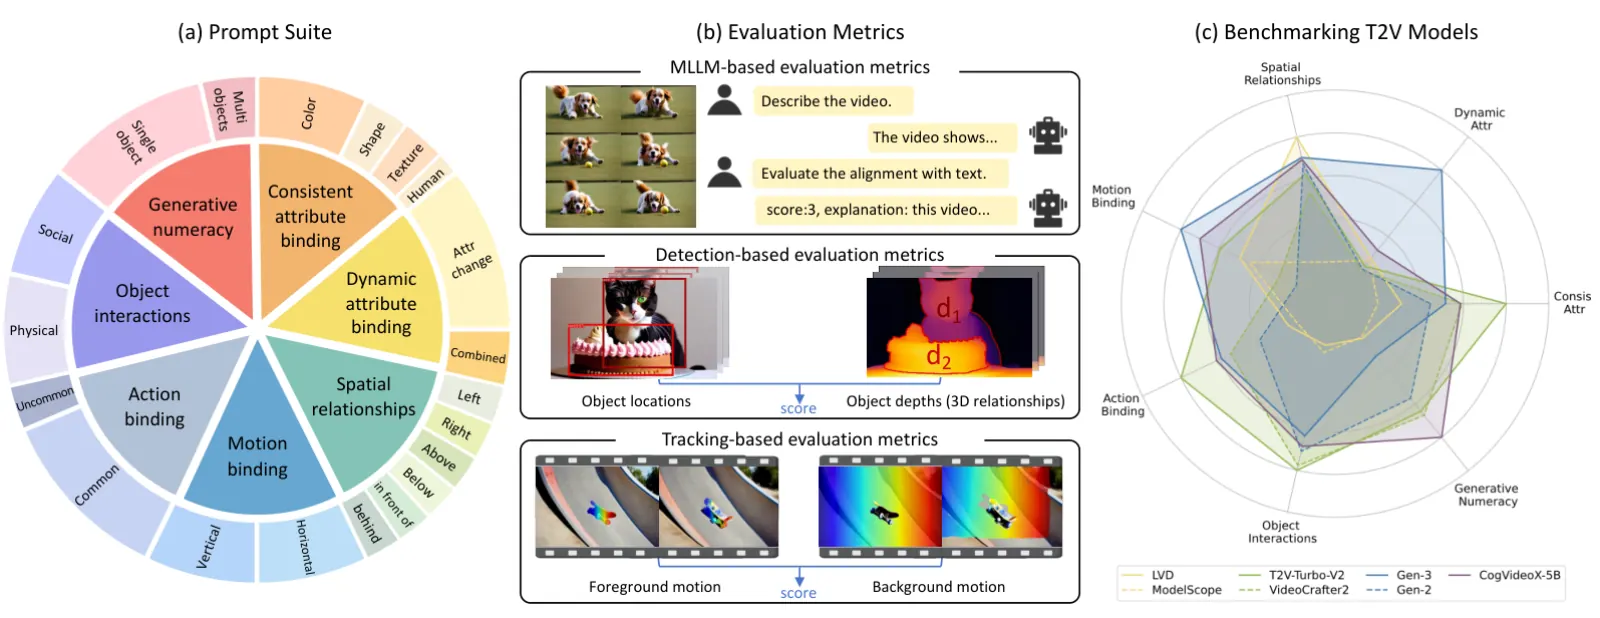
T2V-CompBench(港大,联合港中文与华为诺亚)问的是文生视频模型会不会把正确的属性、动作和运动绑到正确的物体上。这是组合能力,不是单一美学分。官方套件 1,400 条 prompt(7 × 200):
- 一致 / 动态属性绑定 — 先测静态属性,再测时变属性,是否落在正确物体上。
- 空间关系 — 二维 / 三维布局(检测 + 深度 / SAM)。
- 运动绑定 — 前景 vs 背景运动(DOT 跟踪)。
- 动作绑定 与 物体交互 — MLLM(LLaVA 风格)评判。
- 生成计数 — GroundingDINO 数物体。这是 WorldFoundry 已在真实 MP4 上跑过的有界官方分量。
论文:T2V-CompBench。项目:t2v-compbench-2025.github.io。代码:KaiyueSun98/T2V-CompBench。参考视频:Kaiyue/T2V-CompBench-Videos(25,200 行)。
WorldFoundry 内置官方 runtime,并用严格的 manifest 桥把生成视频排成 category/NNNN.mp4。可导入官方 CSV / JSON,或在度量资源就位后跑单个类别。只有七个类别分齐备时才写出 t2v_compbench_average。
评测维度
- 一致属性绑定类型类别
把静态属性(颜色、材质)绑定到正确物体,并在整段视频中保持。
- 动态属性绑定类型类别
在正确物体上实现时变属性(变红、长大、融化)。
- 空间关系类型类别
用检测加深度/SAM 打分的二维/三维空间布局。
- 运动绑定类型类别
用 DOT 跟踪打分的前景/背景运动绑定。
- 动作绑定类型类别
把请求的动作绑定到正确主体,由 MLLM 评判。
- 物体交互类型类别
物体之间的交互是否一致,由 MLLM 评判。
- 生成计数类型类别
用 GroundingDINO 检测打分的物体计数。仓内已对有界官方分量做过验证。
数据组成
- 规模
1,400 条组合式 T2V prompt:7 个组合轴各 200 条。Hugging Face 另有 25,200 条官方参考视频。
- 来源
Kaiyue/T2V-CompBench-Videos · github.com
- 模态
text · video
- 许可证
unknown_pending_review
- 说明
WorldFoundry 内置官方 runtime。只有七个类别分齐备时才写出全套平均分。
指标
指标
- 方向越高越好
consistent_attribute_bindingT2V-CompBench MLLM 得分:静态属性与正确物体的绑定。
- 方向越高越好
dynamic_attribute_bindingT2V-CompBench MLLM 得分:时变属性变化与绑定。
- 方向越高越好
spatial_relationshipsT2V-CompBench 检测/深度得分:2D 与 3D 空间关系。
- 方向越高越好
motion_bindingT2V-CompBench 跟踪得分:前景/背景运动绑定。
- 方向越高越好
action_bindingT2V-CompBench MLLM 得分:动作-物体绑定。
- 方向越高越好
object_interactionsT2V-CompBench MLLM 得分:物体间交互一致性。
- 方向越高越好
generative_numeracyT2V-CompBench 检测得分:生成物体计数。
- 方向越高越好
t2v_compbench_average仅当七个官方 T2V-CompBench 类别分齐备时输出的均值。
主指标T2V-CompBench Average
Leaderboard
官方实时榜,嵌在本页。不是 WorldFoundry 跑分。 Hugging Face Space(Kaiyue).
如何运行
导入官方类别分:
worldfoundry-eval zoo benchmark-run \
  --benchmark-id t2v-compbench \
  --mode official-validation \
  --official-results-path <official_results.json> \
  --generated-artifact-dir <generated_videos> \
  --output-dir tmp/t2v-compbench/official-validation \
  --json
从已就位视频重算一个类别(计数需要 GroundingDINO 与 BERT 兼容编码器):
${WORLDFOUNDRY_UNIFIED_PYTHON} \
  worldfoundry/evaluation/tasks/execution/runners/t2v_compbench/run_t2v_compbench_official_runner.py \
  --generated-video-dir <generated_videos_with_t2v_compbench_generation_manifest.jsonl> \
  --category generative_numeracy \
  --output-dir tmp/t2v-compbench/numeracy \
  --json
--preflight 会在开跑前检查资源。MLLM 类别需要 WORLDFOUNDRY_T2V_COMPBENCH_LLAVA_MODEL_PATH;运动绑定需要 DOT;空间类别需要 Depth-Anything / SAM(WORLDFOUNDRY_T2V_COMPBENCH_SAM_CKPT)。共享栈:grounded_depth_segmentation_stack。默认导入路径:WORLDFOUNDRY_T2V_COMPBENCH_RESULTS_PATH。可选 runtime 根:WORLDFOUNDRY_T2V_COMPBENCH_ROOT。
仓内指针:
worldfoundry/data/benchmarks/tasks/external/t2v-compbench.yaml
worldfoundry/evaluation/tasks/execution/runners/t2v_compbench/runtime/t2v_compbench
产物包括 scorecard.json(齐备时主键 t2v_compbench_average)、raw_metric_table.jsonl,以及来源提供时的逐样本行。