Show-o
Show-o(National University of Singapore (Show Lab)):文生图;已验证。
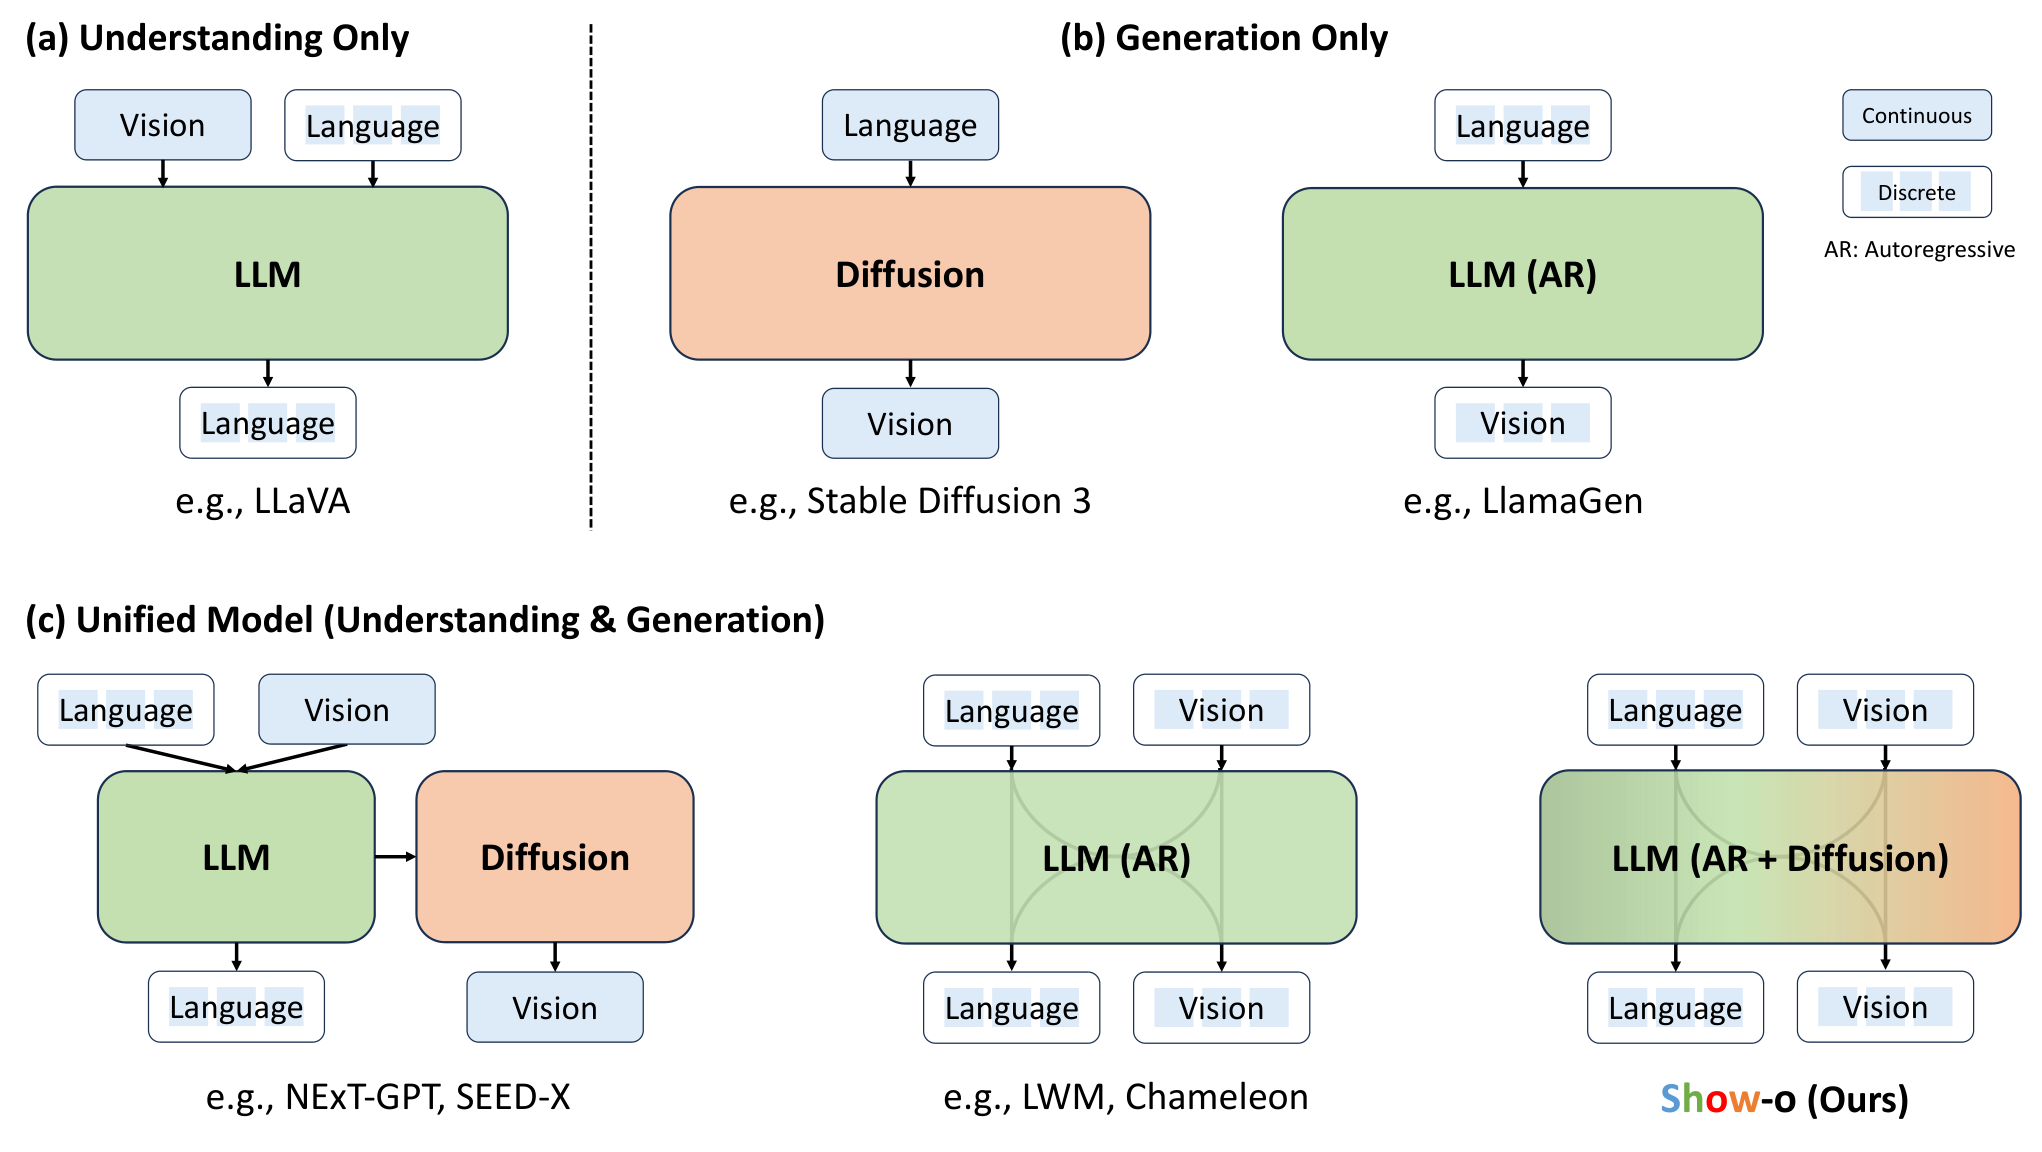
Show-o(Xie 等,新加坡国立大学 Show Lab 与 ByteDance,arXiv 2408.12528)是一个 1.3B 的单一 Transformer,把多模态理解与生成放在同一套权重里。它从 Phi-1.5 初始化,而不是把独立扩散专家接到 MLLM 上。
记录论文为Show-o: One Single Transformer to Unify Multimodal Understanding and Generation(ICLR 2025, 2024)。
项目页:showlab.github.io/Show-o。代码:showlab/Show-o。
构建运行命令
ShowOPipelineworldfoundry.pipelines.component_pipelinesdefaultworldfoundry.pipelineworldfoundry-eval run \
show-o \
--pipeline.task-profile default \
--json用来做什么
任务是 catalog 静帧而不是视频时,用 show-o。
Transformer 是带逐层 QK-Norm 的 Phi-1.5,词表额外增加 8,192 个可学习图像 token。统一 prompt 用 [MMU]/[T2I] 标明任务,用 [SOT]/[EOT]、[SOI]/[EOI] 框住文本与图像。训练同时做 mask-token prediction 与 next-token prediction(L_MTP + α L_NTP)。生成从全 [MASK] 开始、按 T 步逐步揭开,步数大约是自回归解码图像的 1/20;树内运行时默认 256 像素、CFG 3.0、18 步。该模型由新加坡国立大学(Show Lab)发布。
catalog 记录的任务包括 multimodal-generation、文生图。别名包括 show_o、showo。模态上,它接受文本、图像,输出图像、文本。
运行时契约
可选 prompt、input_path、interactions、fps、guidance_scale;产物 show_o.png。
CLI task profile:default。绑定的 pipeline 类是 ShowOPipeline。
系列状态:已验证。
已验证的 WorldFoundry 路径仅 T2I——请相应设置 mode,预期产物为 generated_image。 论文默认分辨率 256;封装使用 classifier-free guidance(默认 3.0)和 18 步离散扩散。 权重为 MIT,位于 showlab/show-o,并记录 MAGVIT-v2 与 Phi-1.5。 论文中的图像理解与编辑模式此处尚未接线。
仅接通文生图;MMU、补全与外推是后续工作。
在 WorldFoundry 中运行
catalog 启动命令是 worldfoundry-eval run show-o --pipeline.task-profile default。上方命令构建器按已记录任务切换 --pipeline.task-profile,发出的仍是 worldfoundry-eval run。
运行环境是统一 profile worldfoundry-unified-cu128(Python 3.11,CUDA 11.3)。
记录的权重仓库包括 showlab/show-o、showlab/magvitv2、microsoft/phi-1_5。准备环境并检查本地资产:bash scripts/inference/prepare_model_infer.sh show-o;下载缺失的公开权重时加 --download。
记录 license 为 mit;状态:已验证。