
BEHAVIOR-1K
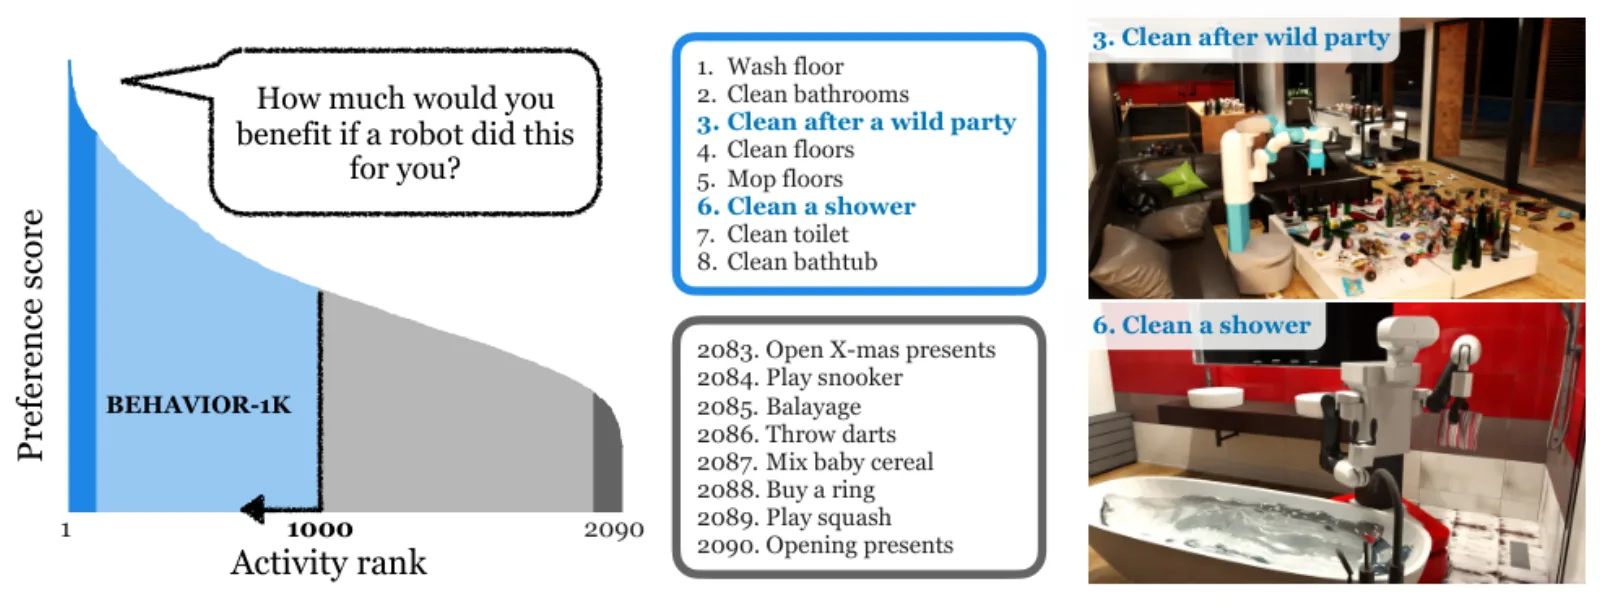
BEHAVIOR-1K 是斯坦福 Vision & Learning Lab 的人本具身评测:从人类时间使用调查里选出 1000 项日常活动(清洁、烹饪、整理),用 BDDL 谓词语言书写,在 OmniGibson 里仿真,带流体、物体状态和家居物理。成功是逻辑目标是否满足,不是像素分。子目标满足率是部分分。
论文:BEHAVIOR-1K。项目:behavior.stanford.edu。模拟器 / 代码:StanfordVL/OmniGibson(本 catalog 记为 upstream_terms)。
WorldFoundry 导入官方 OmniGibson 结果导出。它不内置 OmniGibson、那 1000 项活动定义或策略 checkpoint。那些遵循斯坦福文档。
评测维度
- 1000 项家务活动类型套件
从人类时间使用调查中抽样的活动(清洁、烹饪、整理),用 BDDL 描述。
- BDDL 子目标类型轴
成功由逻辑目标是否满足定义;子目标率为部分分。
数据组成
- 规模
斯坦福 BEHAVIOR-1K:在 OmniGibson 中的 1000 项日常活动,含真实物理、流体与物体状态。目标是 BDDL 逻辑谓词,不是单一像素指标。
- 来源
github.com
- 模态
language · vision · action · state
- 许可证
upstream_terms
- 说明
WorldFoundry 导入官方 OmniGibson 结果导出;仓内不跑 OmniGibson。
指标
指标
- 方向越高越好
success_rate评测 rollout 上的主成功率(逐 episode 成功比例)。
主指标Success Rate
- 方向越高越好
task_success按任务聚合的成功率。
- 方向越高越好
episode_success逐 episode 成功指示的聚合值。
- 方向越高越好
subgoal_successBDDL 子目标满足率(部分得分)。
Leaderboard
论文报告结果(非实时榜;不是 WorldFoundry 跑分)。 论文报告的三项活动之一上的作者 RL 基线。 BEHAVIOR-1K: A Human-Centered, Embodied AI Benchmark with 1,000 Everyday Activities and Realistic Simulation (2024).
| 模型 | StoreDecoration 成功率 |
|---|---|
| RL-Prim.Hist. | 0.55 |
| RL-Prim. | 0.48 |
| RL-VMC | 0.0 |
如何运行
worldfoundry-eval zoo benchmark-run \
  --benchmark-id behavior1k \
  --mode official-validation \
  --official-results-path <official_results.json> \
  --output-dir tmp/behavior1k/official-validation \
  --json
可选的 WORLDFOUNDRY_BEHAVIOR1K_ROOT 指向本地 OmniGibson / 活动根目录。默认导入路径:WORLDFOUNDRY_BEHAVIOR1K_RESULTS_PATH。清单:worldfoundry/data/benchmarks/tasks/external/behavior1k.yaml。产物:scorecard.json(主键 success_rate;另有 subgoal_success)、raw_results.jsonl、evaluation/summary.json。