RBench
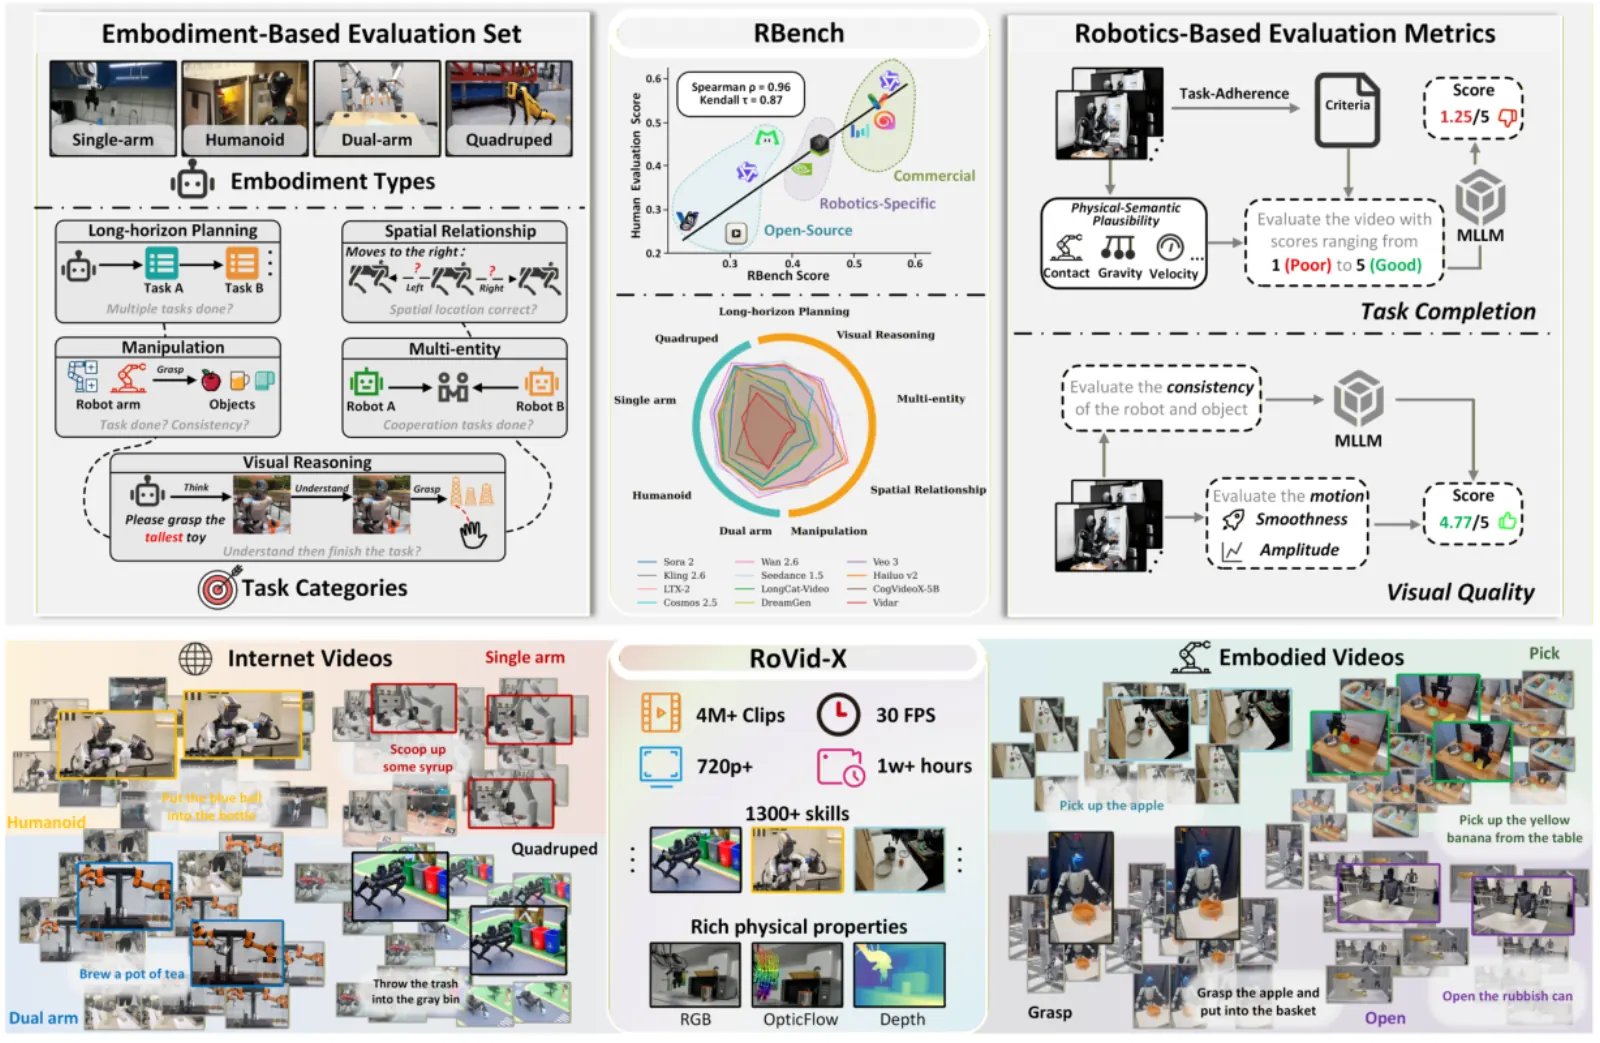
RBench(ReVidgen;北大 DAGroup 与字节 Seed;ICML 2026)评的是 面向机器人的图像生成视频。650 条图文样本:
- 任务赛道 — 250 条:常见操作、长程规划、多实体协作、空间关系、视觉推理。
- 本体赛道 — 400 条:双臂、人形、单臂、四足。
视频由 VLM judge(GPT 或 Qwen3-VL)打物理合理性、任务遵守与稳定性,外加 GroundingDINO / SAM2 / CoTracker / Q-Align 的算子指标(运动平滑 / 幅度)。论文报告与人类 0.96 Spearman。配套训练数据:RoVid-X(400 万条标注机器人片段)。许可证:CC-BY-4.0。
论文:RBench。代码:DAGroup-PKU/ReVidgen。数据:DAGroup-PKU/RBench。
WorldFoundry 复现官方 eval/4_embodiments 与 eval/5_tasks 聚合(选项到分数映射、min-max、PAS 与一致性惩罚、幅度过滤)。不跑 VLM 或算子栈。rbench_overall 是两条赛道分的 WorldFoundry 合成值,不是已发表的 RBench 数字。GPT 与 Qwen 输出从不混用。
评测维度
- 任务赛道类型赛道
250 条图文:常见操作、长程规划、多实体协作、空间关系、视觉推理。
- 本体赛道类型赛道
400 条:双臂、人形、单臂、四足。
数据组成
- 规模
北大 / 字节 Seed 机器人 I2V 评测(ICML 2026)。650 条图文。VLM + GroundingDINO/SAM2/CoTracker/Q-Align 算子。CC-BY-4.0。论文报告与人类 0.96 Spearman。
- 来源
DAGroup-PKU/RBench · DAGroup-PKU/RoVid-X · github.com
- 划分
dual_arm · humanoid · single_arm · quad · common_manipulation · long-horizon_planning · multi-entity_collaboration · spatial_relationship · visual_reasoning
- 模态
image · text · video
- 许可证
CC-BY-4.0
- 说明
WorldFoundry 聚合官方 eval/4_embodiments 与 eval/5_tasks 树。rbench_overall 是 WorldFoundry 合成值,不是已发表数字。GPT 与 Qwen 从不混用。
指标
指标
- 方向越高越好
rbench_overallWorldFoundry 对两条官方赛道得分的合成均值;不是已发表的 RBench 数字。
主指标RBench Overall
- 方向越高越好
embodiment_overall四种机器人本体上任务完成与视觉质量的汇总。
- 方向越高越好
task_completion归一化物理合理性与任务遵循一致性的均值。
- 方向越高越好
visual_quality扣除幅度与一致性罚分后的加权稳定性与平滑度得分。
- 方向越高越好
visual_quality_base0.8 × 机器人主体稳定性 + 0.2 × 运动平滑度(未扣分前)。
- 方向越高越好
physical_plausibility由 1-5 分制归一化的 VLM 物理合理性得分。
- 方向越高越好
task_adherence_consistency由 1-5 分制归一化的 VLM 任务遵循得分。
- 方向越高越好
robot_subject_stability由 1-15 选项映射分制归一化的 VLM 机器人与物体稳定性得分。
- 方向越高越好
motion_smoothness运动平滑度算子得分。
- 方向越高越好
motion_amplitude驱动 PAS 扣分的机械臂可感知幅度算子得分。
- 方向越高越好
task_track_overall五个任务分组内所有已评分视频的 ALL_TASKS_MEAN 汇总。
- 方向越高越好
common_manipulationcommon manipulation(常规操作)分组的归一化 rubric 得分。
- 方向越高越好
long_horizon_planninglong-horizon planning(长时程规划)分组的归一化 rubric 得分。
- 方向越高越好
multi_entity_collaborationmulti-entity collaboration(多实体协作)分组的归一化 rubric 得分。
- 方向越高越好
spatial_relationshipspatial relationship(空间关系)分组的归一化 rubric 得分。
- 方向越高越好
visual_reasoningvisual reasoning(视觉推理)分组的归一化 rubric 得分。
Leaderboard
论文报告结果(非实时榜;不是 WorldFoundry 跑分)。 论文人机对齐表的 RBench 列。 Rethinking Video Generation Model for the Embodied World (2026).
| 模型 | RBench 分数 |
|---|---|
| Wan 2.5 | 0.570 |
| Hailuo v2 | 0.565 |
| Veo 3 | 0.563 |
| Seedance 1.0 | 0.551 |
| Cosmos 2.5 | 0.464 |
| LongCat-Video | 0.437 |
| Wan2.1-14B | 0.399 |
| CogVideoX-5B | 0.256 |
如何运行
hf download DAGroup-PKU/RBench --repo-type dataset --local-dir <rbench_data_root>

worldfoundry-eval zoo benchmark-run \
  --benchmark-id rbench \
  --mode official-validation \
  --official-results-path <rbench_results_root> \
  --result-model-id <model_id> \
  --output-dir tmp/rbench/official-validation \
  --json
--track 限制到一条赛道。两边都有结果时用 --vlm-backend 选 GPT 或 Qwen。--generated-artifact-dir 增加覆盖报告。环境变量:WORLDFOUNDRY_RBENCH_RESULTS_PATH、WORLDFOUNDRY_RBENCH_DATA_ROOT、WORLDFOUNDRY_RBENCH_VLM_BACKEND。
仓内指针:worldfoundry/data/benchmarks/tasks/external/rbench.yaml,worldfoundry/evaluation/tasks/execution/runners/rbench。
产物包括 scorecard.json(主键 rbench_overall)与 track_breakdown.json。