MIND
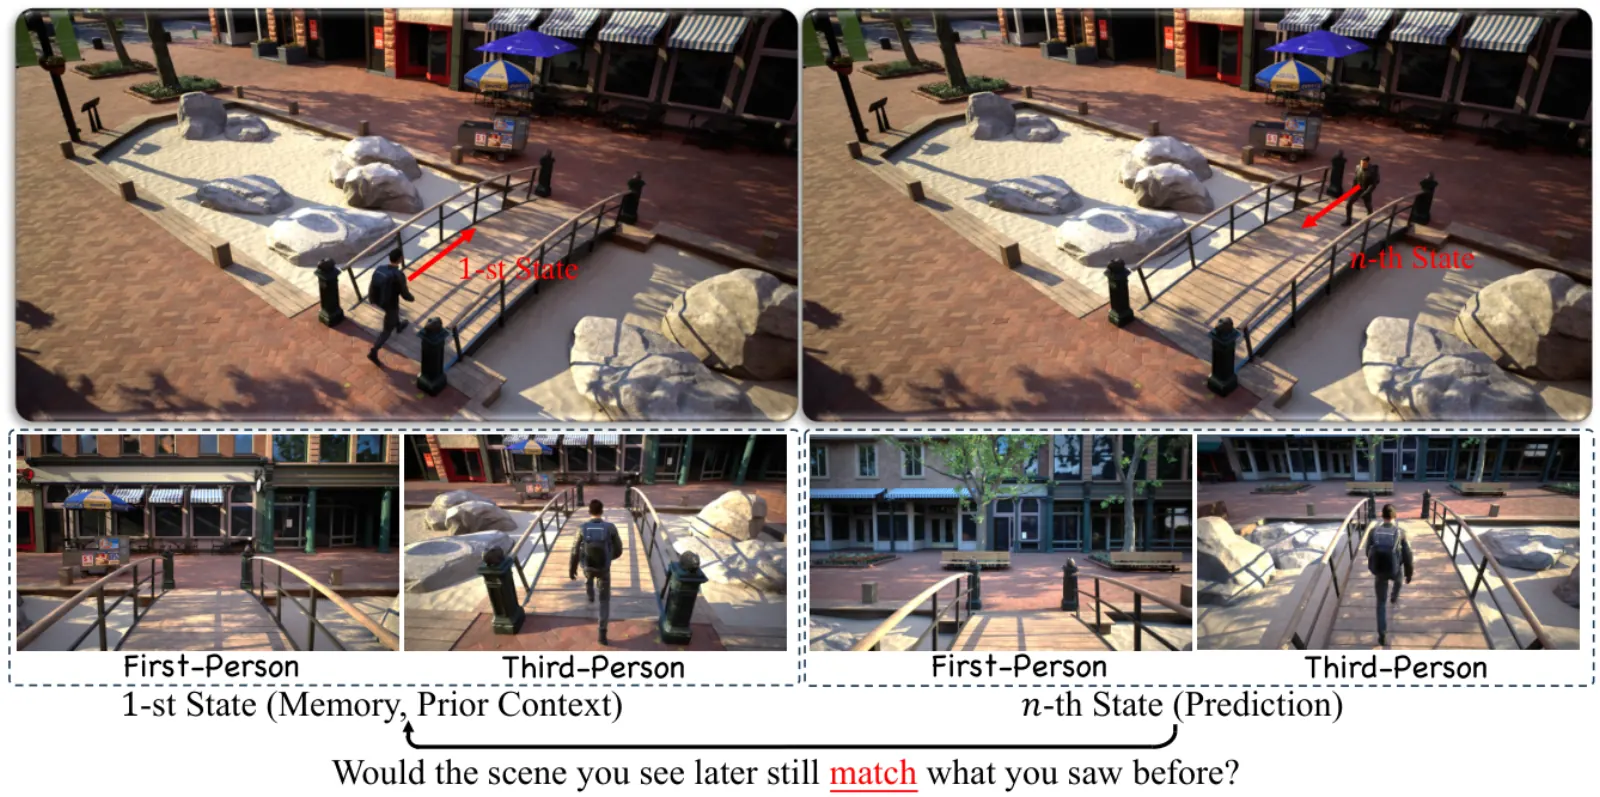
MIND(中南大学 CSU-JPG)是开放域闭环回访评测:模型在相机 / 动作指令下 rollout,离开某区域后再返回。官方 MIND-Data 是 250 段虚幻引擎 5 视频,1080p / 24 FPS,覆盖八类场景(40+ 环境)。200 段共享同一动作空间(第一 / 第三人称各 100);50 段使用变化的速度与旋转角(各 25)。打分包括长上下文记忆(PSNR / SSIM / LPIPS / MSE + DINOv3 patch MSE)、视觉质量(MUSIQ-SPAQ、LAION 美学)、动作控制(ViPE 相对位姿误差),以及考察通用场景一致性的镜像测试。布局:<model>/{1st,3rd}_data/<test_type>/<name>/video.mp4。项目把公开 leaderboard 标为即将开放。
论文:MIND。项目:csu-jpg.github.io/MIND.github.io。代码:CSU-JPG/MIND(MIT)。数据集:CSU-JPG/MIND。
WorldFoundry 内置指标 runtime(run_mind_official_runner.py)。--run-official 对就位的真值与生成视频打分;--official-results-path 导入已完成的 MIND JSON;--run-fixture 是无 GPU 的归一化检查。本页不跑世界模型推理。mind_average(以及四个能力组得分)是 WorldFoundry 派生值——MIND 官方不发布综合分。
评测维度
- 长上下文记忆类型轴
离开某区域再返回。用 PSNR / SSIM / LPIPS / MSE 以及 DINOv3 patch token MSE 把续写与真值对比。
- 视觉质量类型轴
MUSIQ-SPAQ 成像质量(上游除以 100)与 LAION CLIP ViT-L/14 美学分(上游除以 10)。
- 动作控制(ViPE)类型轴
生成视频与真值视频 ViPE 轨迹间的相对位姿误差。需要 ViPE checkout。
- 镜像测试场景一致性类型轴
播放一段 rollout 与其时间反转的后半段(GSC PSNR / SSIM / LPIPS / MSE)。
- 第一 / 第三人称 × 动作空间类型划分
100+100 段共享同一动作空间;25+25 段使用变化的速度/角度。布局:<model>/{1st,3rd}_data/<test_type>/…
数据组成
- 规模
中南大学 CSU-JPG 的开放域闭环回访评测。250 段虚幻引擎 5 视频,1080p / 24 FPS,覆盖八类场景(自然、城市、室内、载具、科幻、风格化、奇幻、抽象;40+ 环境)。共享动作空间:第一 / 第三人称各 100 段。变化动作空间:各 25 段。Hugging Face:CSU-JPG/MIND。官方 leaderboard 标注即将开放。
- 来源
CSU-JPG/MIND · github.com
- 划分
standard
- 模态
video · action
- 许可证
MIT
- 说明
WorldFoundry 内置指标 runtime,对已生成视频打分。它不生成这些视频。mind_average 是 WorldFoundry 聚合值——MIND 官方不发布综合分。
指标
指标
- 方向越高越好
lcm_psnr预测延续段与真值帧间的长上下文记忆 PSNR。
- 方向越高越好
lcm_ssim相对真值延续段的长上下文记忆 SSIM。
- 方向越低越好
lcm_lpips长上下文记忆 LPIPS(AlexNet)相对真值延续段;越低越好。
- 方向越低越好
lcm_mse相对真值延续段的长上下文记忆像素 MSE;越低越好。
- 方向越低越好
dino_mse预测帧与真值帧的 L2 归一化 DINOv3 patch token 间 MSE;越低越好。
- 方向越高越好
imaging_quality生成帧的 MUSIQ-SPAQ 成像质量(上游除以 100)。
- 方向越高越好
aesthetic_qualityLAION CLIP ViT-L/14 美学预测器得分(上游除以 10)。
- 方向越低越好
action_rpe_trans_mean生成视频与真值视频 ViPE 轨迹间的平均平移相对位姿误差;越低越好。
- 方向越低越好
action_rpe_rot_mean_deg两条 ViPE 轨迹间的平均旋转相对位姿误差(度);越低越好。
- 方向越低越好
action_rpe_trans_median所有有效动作步上平移相对位姿误差的中位数;越低越好。
- 方向越低越好
action_rpe_rot_median_deg所有有效动作步上旋转相对位姿误差的中位数(度);越低越好。
- 方向越低越好
action_translation_rpe_trans_mean限定纯平移动作的平均平移 RPE;越低越好。
- 方向越低越好
action_rotation_rpe_rot_mean_deg限定纯相机旋转动作的平均旋转 RPE(度);越低越好。
- 方向越高越好
gsc_psnr镜像测试 rollout 与其时间反转半段间的一般场景一致性 PSNR。
- 方向越高越好
gsc_ssim镜像测试 rollout 上的一般场景一致性 SSIM。
- 方向越低越好
gsc_lpips镜像测试 rollout 上的一般场景一致性 LPIPS;越低越好。
- 方向越低越好
gsc_mse镜像测试 rollout 上的一般场景一致性像素 MSE;越低越好。
- 方向越高越好
memory_consistency_scoreWorldFoundry 派生的归一化 LCM 与 DINOv3 组件指标均值。
- 方向越高越好
visual_quality_scoreWorldFoundry 派生的归一化成像与美学指标均值。
- 方向越高越好
action_control_scoreWorldFoundry 派生的归一化整体 RPE 平移与旋转指标均值。
- 方向越高越好
scene_consistency_scoreWorldFoundry 派生的归一化镜像测试 GSC 指标均值。
- 方向越高越好
mind_averageWorldFoundry 派生的可用 MIND 能力组得分均值。MIND 官方不发布综合分,该值绝不是 leaderboard 数字。
主指标MIND Average
Leaderboard
论文报告结果(非实时榜;不是 WorldFoundry 跑分)。 表 2 第一人称划分。MSE 越低越好。项目页仍把公开实时榜标为即将开放。 MIND: Benchmarking Memory Consistency and Action Control in World Models (2026).
| 模型 | 长上下文记忆(越低越好,MIND-First 50) |
|---|---|
| MIND-Worldvideo-to-world | 0.1035 |
| MIND-Worldimage-to-world | 0.1091 |
| Matrix-Game 2.0image-to-world | 0.1188 |
如何运行
无 GPU 的 fixture:
python worldfoundry/evaluation/tasks/execution/runners/mind/run_mind_official_runner.py \
  --run-fixture \
  --output-dir tmp/mind/fixture \
  --json
对已就位真值与模型输出打分(DINOv3 用 --dino-path;需要动作指标时用 --vipe-repo):
${WORLDFOUNDRY_UNIFIED_PYTHON} \
  worldfoundry/evaluation/tasks/execution/runners/mind/run_mind_official_runner.py \
  --run-official \
  --gt-root /path/to/MIND-Data \
  --generated-artifact-dir "${WORLDFOUNDRY_GENERATED_ARTIFACT_DIR}" \
  --dino-path /path/to/dinov3_vitb16 \
  --output-dir tmp/mind/official \
  --json
导入已完成的 MIND 结果 JSON:
worldfoundry-eval zoo benchmark-run \
  --benchmark-id mind \
  --mode official-validation \
  --official-results-path <mind_result.json> \
  --output-dir tmp/mind/official-validation \
  --json
--metrics 是逗号列表(lcm,visual,dino,action,gsc;默认全开)。--video-max-time 限制除动作外所有指标的帧数。DINOv3 权重默认 ./dinov3_vitb16,也可用 --dino-path / WORLDFOUNDRY_MIND_DINO_PATH。指标栈额外 pip 钉在 worldfoundry/data/benchmarks/requirements/mind.txt。动作打分还要 ViPE checkout(--vipe-repo)。
仓内 src/process.py 可按 GPU 分发:视频进队列,空闲 GPU 取任务,失败回队,每完成一条就重写结果 JSON,便于读中间结果。支持的入口是 WorldFoundry --run-official,不要把 src/process.py 当成第二套公开 CLI。
可变状态(工作目录、MIND_CACHE_DIR、日志)都写在 --output-dir 下。环境变量:WORLDFOUNDRY_MIND_ROOT、WORLDFOUNDRY_MIND_RESULTS_PATH、WORLDFOUNDRY_GENERATED_ARTIFACT_DIR。清单:worldfoundry/data/benchmarks/tasks/external/mind.yaml。产物:scorecard.json(主键 mind_average)、raw_metric_table.jsonl、per_sample_scores.jsonl、benchmark_contract.json。
生成视频与真值布局
--generated-artifact-dir 必须对齐视角与测试类型。{corresponding data name} 是真值文件夹名。镜像测试是十条 path 视频,不是单个 video.mp4:
{model_name}/
  1st_data/
    action_space_test/{name}/video.mp4
    mem_test/{name}/video.mp4
    mirror_test/{any_name}/path-1.mp4 … path-10.mp4
  3rd_data/
    action_space_test/{name}/video.mp4
    mem_test/{name}/video.mp4
    mirror_test/{any_name}/path-1.mp4 … path-10.mp4
官方 MIND-Data(训练 + 测试)类似:
MIND-Data/
  1st_data/
    test/action_space_test/{gt}/action.json + images.txt + video.mp4
    test/mem_test/{gt}/action.json + images.txt + video.mp4
    train/{gt}/action.json + video.mp4
  3rd_data/
    …同样的 test / train 划分…
action.json 字段:
mark_time— 期望预测的起始帧(记忆 / 上下文分界)。total_time— 真值帧数。caption— 文本描述。data[*].time以及ws/ad/ud/lr动作码(0无;1/2两个方向)。actor_pos/actor_rpy;第三人称还有camera_pos/camera_rpy。
官方 Result.json
--official-results-path 与 --run-official 都产出这份官方文档。顶层是 video_max_time 和 data[]。每行有 path、perspective(1st_data / 3rd_data)、test_type(mem_test / action_space_test / mirror_test)、可选 error、mark_time、total_time、sample_frames,以及指标块:
lcm— MSE / LPIPS / SSIM / PSNR 的逐帧与avg_*。visual_quality— 逐帧imaging(MUSIQ-SPAQ)与aesthetic(LAION)及均值。dino— 逐帧dino_mse与avg_dino_mse。action— 滤异常后的 ViPE RPE:__overall__、translation、rotation、other,以及act:<name>(rpe_trans_mean/median、rpe_rot_mean_deg/median_deg、count)。video_results[*].gsc— 镜像测试的通用场景一致性(同样四个像素指标;sample_frames应为2 × mark_time)。
仓内 fixture worldfoundry/data/benchmarks/assets/mind/fixtures/mind_result_fixture.json 只复现该 schema,数字是编的。里面没有上游 MIND 记录——样本 id、帧数和分数都是为了在没有 GPU、ViPE 或官方数据集时跑归一化、聚合和 scorecard 不变量。不能当 MIND 成绩发表。