VLABench
VLABench(复旦大学 OpenMOSS)评的是需要 世界知识与多步推理 的语言条件操作,不只是指令跟随。官方规模:100 个任务类别、MuJoCo 中 2000+ 物体,探测网格 / 纹理理解、空间与语义推理、物理定律理解,以及 VLA 策略与 VLM 规划器的长程规划。
论文:VLABench。代码:OpenMOSS/VLABench。许可证:上游条款。
WorldFoundry 是 官方结果导入器。模拟器执行、策略加载与 rollout 采集仍在上游。scorecard 主键:success_rate。
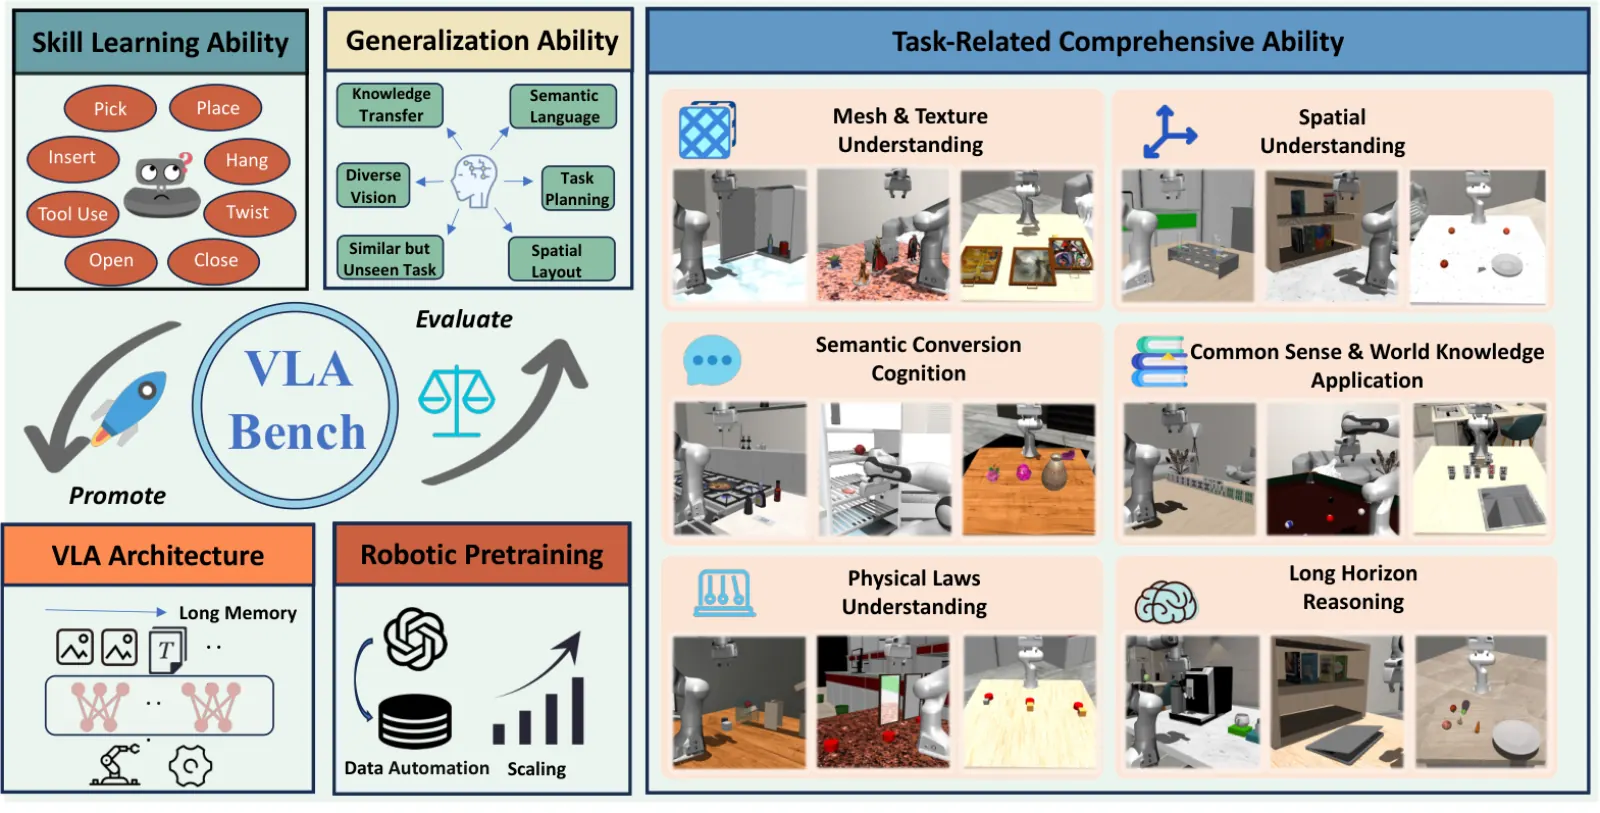
评测维度
- 100 个语言条件类别类型套件
MuJoCo 中的世界知识与多步推理;2000+ 物体。
数据组成
- 规模
复旦 OpenMOSS 语言条件操作评测:100 类任务、MuJoCo 中 2000+ 物体。面向 VLA 策略与 VLM 规划器。
- 来源
github.com
- 模态
language · vision · action · state
- 许可证
upstream_terms
- 说明
WorldFoundry 导入官方 rollout。不启动 MuJoCo,也不加载策略。
指标
指标
- 方向越高越好
success_rate评测 rollout 上的主成功率(逐 episode 成功比例)。
主指标Success Rate
- 方向越高越好
task_success按任务聚合的成功率。
- 方向越高越好
episode_success逐 episode 成功指示的聚合值。
- 方向越高越好
reward平均 episode 奖励 / 回报。
Leaderboard
论文报告结果(非实时榜;不是 WorldFoundry 跑分)。 官方 VLABench 论文表(arxiv 2412.18194)。目录中的 2502.09858 是另一篇论文。 VLABench: A Large-Scale Benchmark for Language-Conditioned Robotics Manipulation with Long-Horizon Reasoning Tasks (2024).
| 模型 | Seen 划分平均成功率 |
|---|---|
| RDT-1B (base) | 15.37 |
| OpenVLA (base) | 11.74 |
| Octo (base) | 1.34 |
如何运行
worldfoundry-eval zoo benchmark-run \
  --benchmark-id vlabench \
  --mode official-validation \
  --official-results-path <official_results.json> \
  --output-dir tmp/vlabench/official-validation \
--json默认导入:WORLDFOUNDRY_VLABENCH_RESULTS_PATH。可选根:WORLDFOUNDRY_VLABENCH_ROOT。
仓内指针:worldfoundry/data/benchmarks/tasks/external/vlabench.yaml。
产物包括 scorecard.json(主键 success_rate)、raw_results.jsonl、evaluation/summary.json。