WorldBench
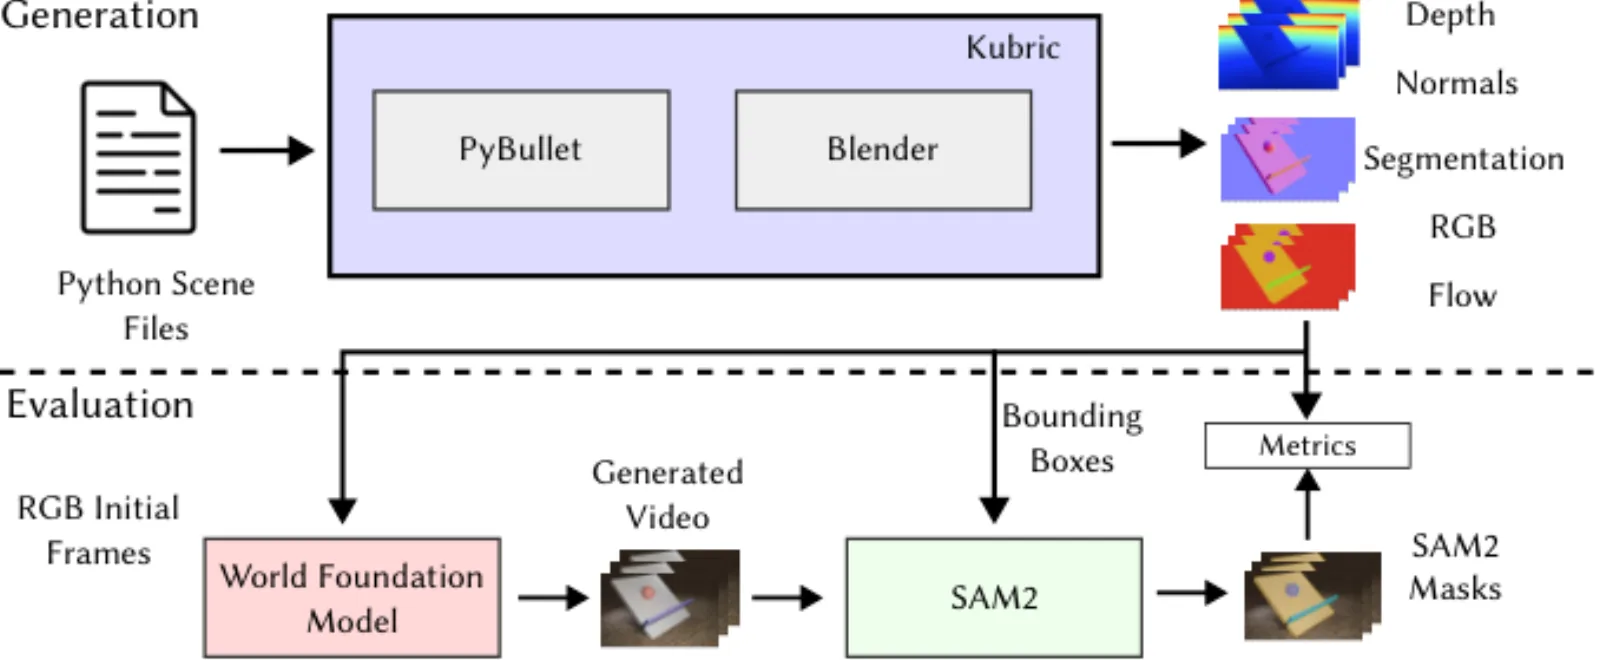
WorldBench(UCLA,联合 Sony AI、耶鲁与 DEVCOM ARL)诊断世界模型离 物理 有多近。Kubric(PyBullet + Blender)渲染 425 个物理准确场景,覆盖运动物理、物体恒存、支撑关系、尺度 / 透视,并带真值深度、法线、分割与光流。模型从初始帧生成续写;SAM2 跟踪首帧框,掩码与仿真比较(前景 mIoU、背景 RMSE)。文本子集另有多选与是否 QA。
公开评测器把 Dice 叫做 “mIoU”。WorldFoundry 分开报 常规 foreground_miou 与发布版的 foreground_dice 兼容值。当前检视的 HF 树是 375 个场景目录(15 情景 × 25),而不是论文的 425。
论文:WorldBench。项目:world-bench.github.io。数据:worldbenchmark/IntuitivePhysics。数据集与评测器 未声明再分发许可证。
WorldFoundry 实现了仓内、模型支撑的 runner。运行时环境仍记录:没有确认可再分发的官方原始视频评测器,以及 从视频做 official-run 不是发布声明。兼容路径是通过 WORLDFOUNDRY_WORLDBENCH_RESULTS_PATH 导入。
评测维度
- 视频 / SAM2 赛道类型赛道
SAM2 跟踪首帧框;掩码对照 Kubric 真值(前景 mIoU、背景 RMSE)。
- 文本 QA 赛道类型赛道
四个物理概念上的多选与是否题。
数据组成
- 规模
UCLA 诊断物理评测。论文:425 个 Kubric 场景(运动、恒存、支撑、尺度)。当前检视的 HF 树是 375 个场景目录。无再分发许可证。公开评测器把 Dice 叫做 mIoU。
- 来源
worldbenchmark/IntuitivePhysics
- 许可证
not_provided
- 说明
仓内 runner 存在,但运行时环境记录没有确认可再分发的官方原始视频评测器。从视频做 official-run 不是发布声明。
指标
指标
- 方向越高越好
foreground_miou按物体、帧、场景平均的常规逐物体 IoU。
主指标Foreground mIoU
- 方向越高越好
foreground_dice公开实现名为 mIoU、实际计算的兼容值。
- 方向越低越好
background_rmse真值分割标为背景的像素上的 RGBA RMSE。
- 方向越高越好
text_based_accuracy可用 WorldBench 文本问题上的严格归一化答案准确率。
- 方向越高越好
multiple_choice_accuracy含显式选项列表的问题的准确率。
- 方向越高越好
binary_accuracyWorldBench 是/否问题的准确率。
Leaderboard
论文报告结果(非实时榜;不是 WorldFoundry 跑分)。 WorldBench: Benchmarking Physical Understanding of World Models by Isolating Physics Concepts (2026).
| 模型 | 平均误差(越低越好) |
|---|---|
| Cosmos-2.5 2B | 0.217 |
| Hunyuan Video 13B | 0.2275 |
| Cosmos-1 DM 7B | 0.231 |
| Cosmos-2 2B | 0.232 |
| Wan 2.2 5B | 0.253 |
| Cosmos-2 14B | 0.274 |
| Cosmos-1 AR 5B | 0.298 |
如何运行
hf download worldbenchmark/IntuitivePhysics --repo-type dataset \
  --local-dir cache/worldfoundry/data/hfd_datasets/worldbenchmark/IntuitivePhysics

${WORLDFOUNDRY_UNIFIED_PYTHON} \
  worldfoundry/evaluation/tasks/execution/runners/worldbench/run_worldbench_official_runner.py \
  --run-official \
  --video-only \
  --dataset-root "${WORLDFOUNDRY_WORLDBENCH_DATASET_ROOT}" \
  --generated-video-dir "${WORLDFOUNDRY_GENERATED_ARTIFACT_DIR}" \
  --sam2-checkpoint "${WORLDFOUNDRY_WORLDBENCH_SAM2_CKPT}" \
  --output-dir tmp/worldbench/video \
  --json
已有掩码时用 --predicted-mask-dir 跳过 SAM2。--text-only 加 --answer-manifest 覆盖 QA。帧对齐:--ground-truth-start-frame、--generated-skip-frames。共享资源:worldbench_dataset_assets、facebook/sam2.1-hiera-large。
仓内指针:worldfoundry/data/benchmarks/tasks/external/worldbench.yaml,worldfoundry/evaluation/tasks/execution/runners/worldbench。
产物包括 scorecard.json(主键 foreground_miou)与 worldbench_evaluation.json。
数据集、视频与帧对齐
仓内 runtime 不 import 上游 checkout。SAM2 来自 worldfoundry.base_models.perception_core.segment.sam2。数据集根必须是公开 HF 布局:
<dataset>/
  scenes/<group>/<scenario>/<scene>/
    rgba_00000.png
    segmentation_00000.png
    …
  textual_questions/*.json
生成续写可以对齐场景 id:
<generated>/<group>/<scenario>/<scene>.mp4
<generated>/<group>/<scenario>/<scene>/output.mp4
<generated>/<group>/<scenario>/<scene>/00000.png
其他视频布局用 --video-manifest(JSON / JSONL / CSV / TSV),每行要有 sample_id 与 video_path。文本预测用 --answer-manifest。稳定 question_id 是 <question-file-stem>:<row>;或同时给 video_name 与 question,因为有的视频有两道题。
评测用 9 帧条件帧。默认生成帧 0 对齐真值帧 9,再打 24 帧续写。若模型把那 9 帧也拼进输出,传 --generated-skip-frames 9。默认值在 worldfoundry/data/benchmarks/assets/worldbench/evaluator.yaml。
原始视频打分默认 facebook/sam2.1-hiera-large。本地权重用 WORLDFOUNDRY_WORLDBENCH_SAM2_CKPT,否则走 HF cache。只导入时用 --official-results-path,不要加 --run-official。
环境用 worldfoundry-unified-cu128。仓内跑通只是集成证据,在全量数值对齐审过之前不会标 leaderboard_valid。检视过的上游钉选 WorldBenchmark/worldbench_eval@4575a164… 没有 license,公开评测器也损坏;出处写在 catalog YAML,没有 SOURCE.json。