HunyuanVideo
腾讯开源文生 / 图生视频 DiT:提示词(及可选参考图)进,视频出。WorldFoundry 原生配方默认 720×1280、129 帧;runner 一致性仍为 pending。
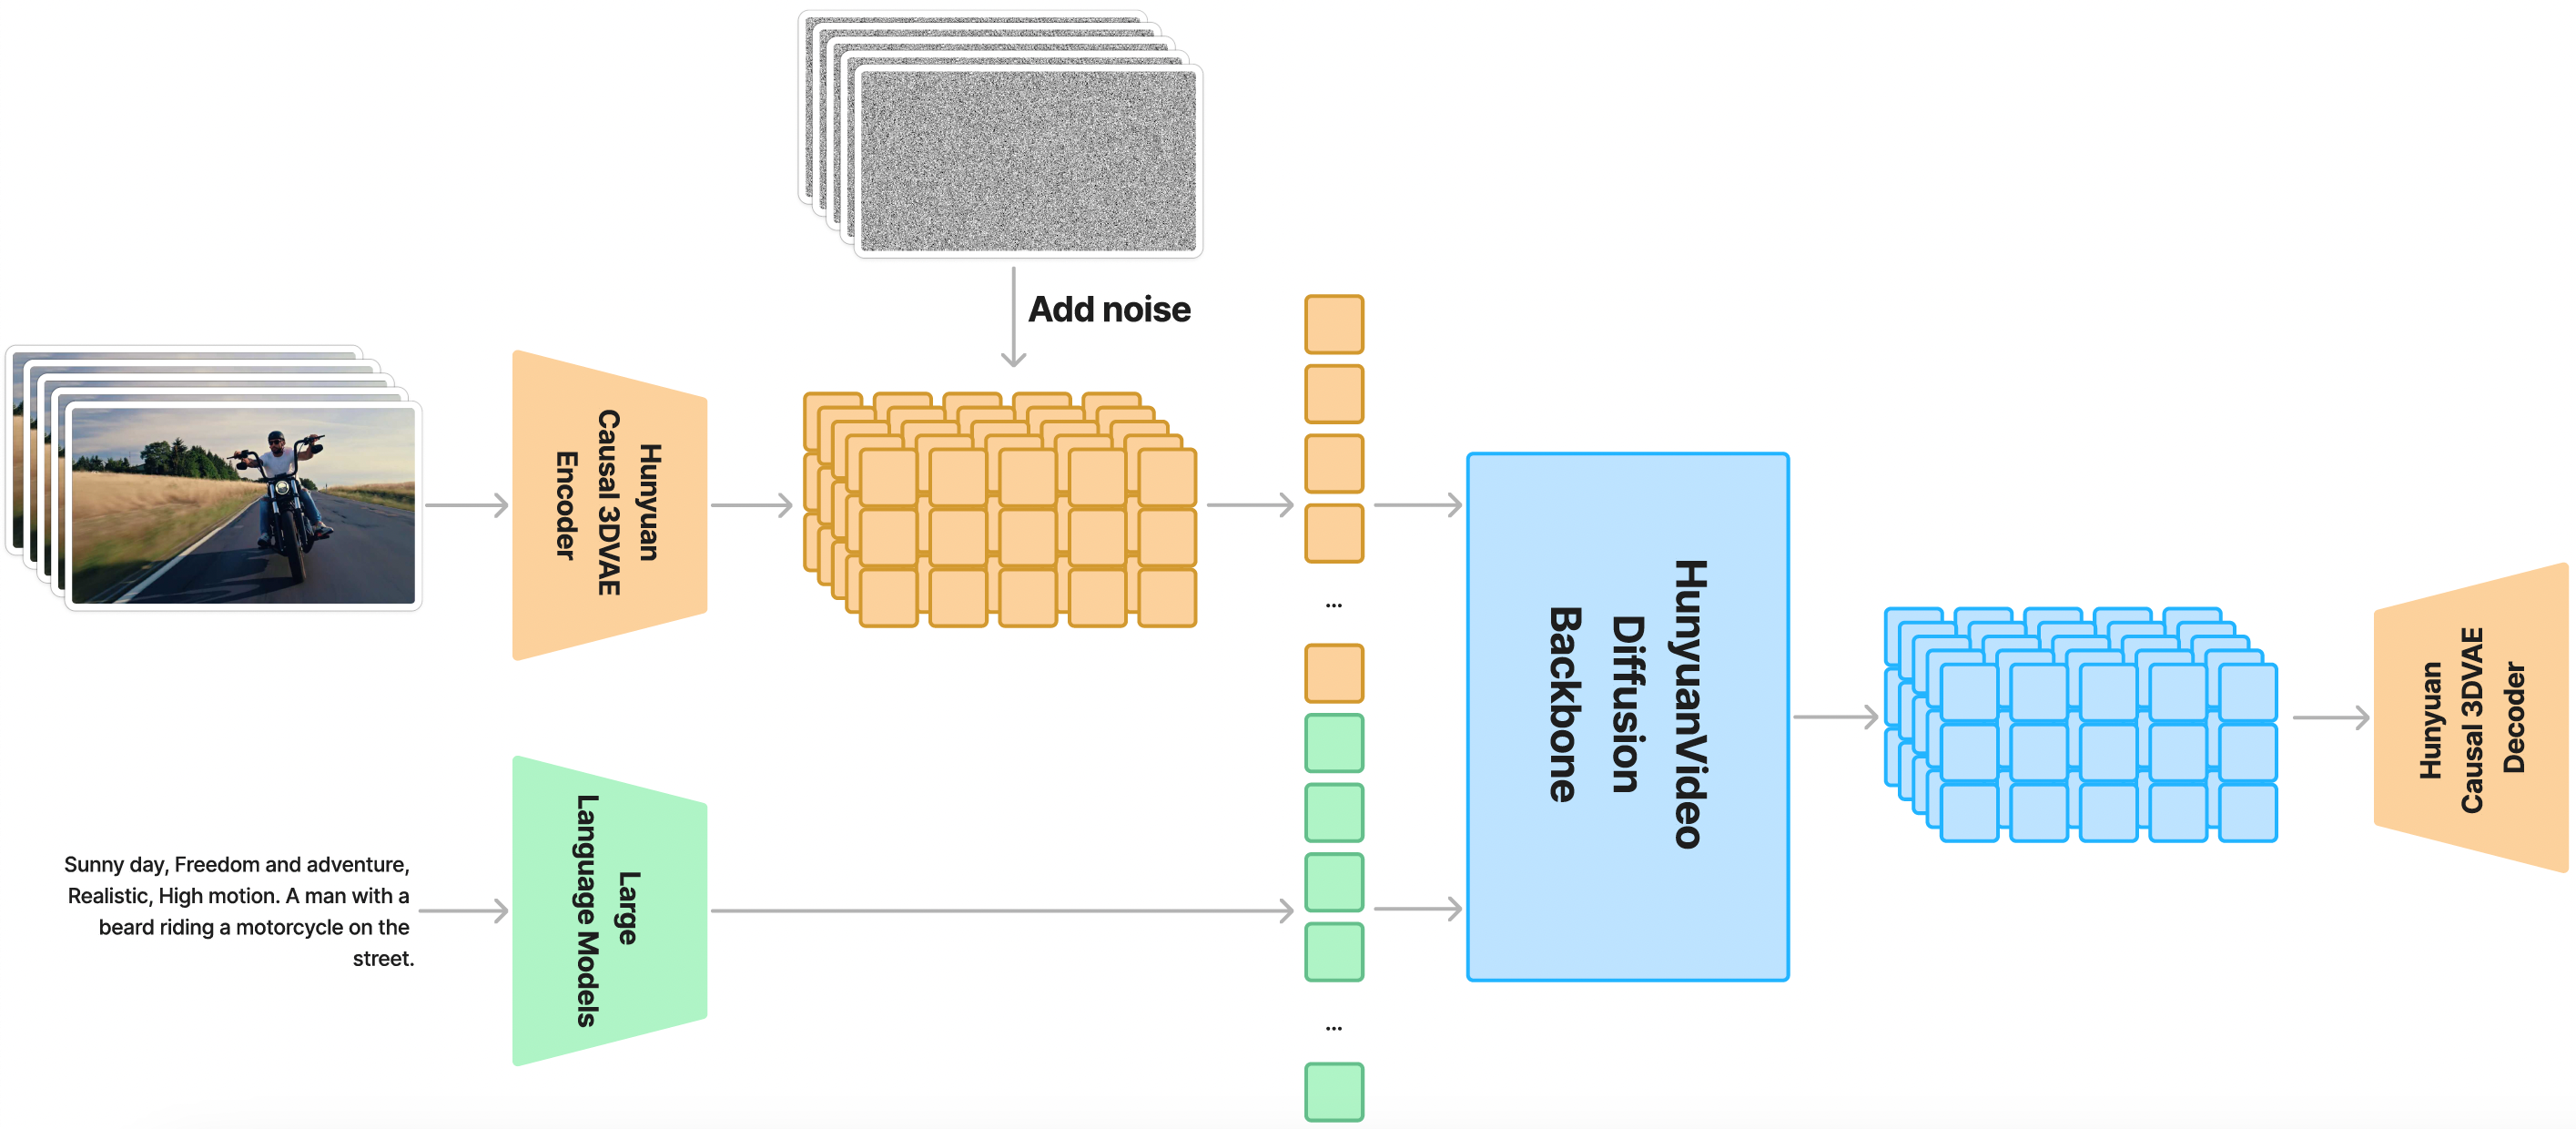
HunyuanVideo 是腾讯的开源视频基础模型:同一套约 130 亿参数的扩散 Transformer 做文生视频和图生视频。运行时生成器以高斯噪声加 MLLM 文本条件为输入,在因果 3D VAE 潜空间上去噪,再解码成图像或视频。
论文为 HunyuanVideo: A Systematic Framework For Large Video Generation Model(arXiv, 2024)。专业人工评测使用 1,533 条 prompt、每个 prompt 仅推理一次、60 多名评估人员;综合指标上优于 Runway Gen-3、Luma 1.6 和 3 个中文社区表现最好的视频生成模型,运动质量尤为突出。该对比基于高质量版本,与已发布的 fast 版本不同。这些是上游数字,不是 WorldFoundry scorecard。
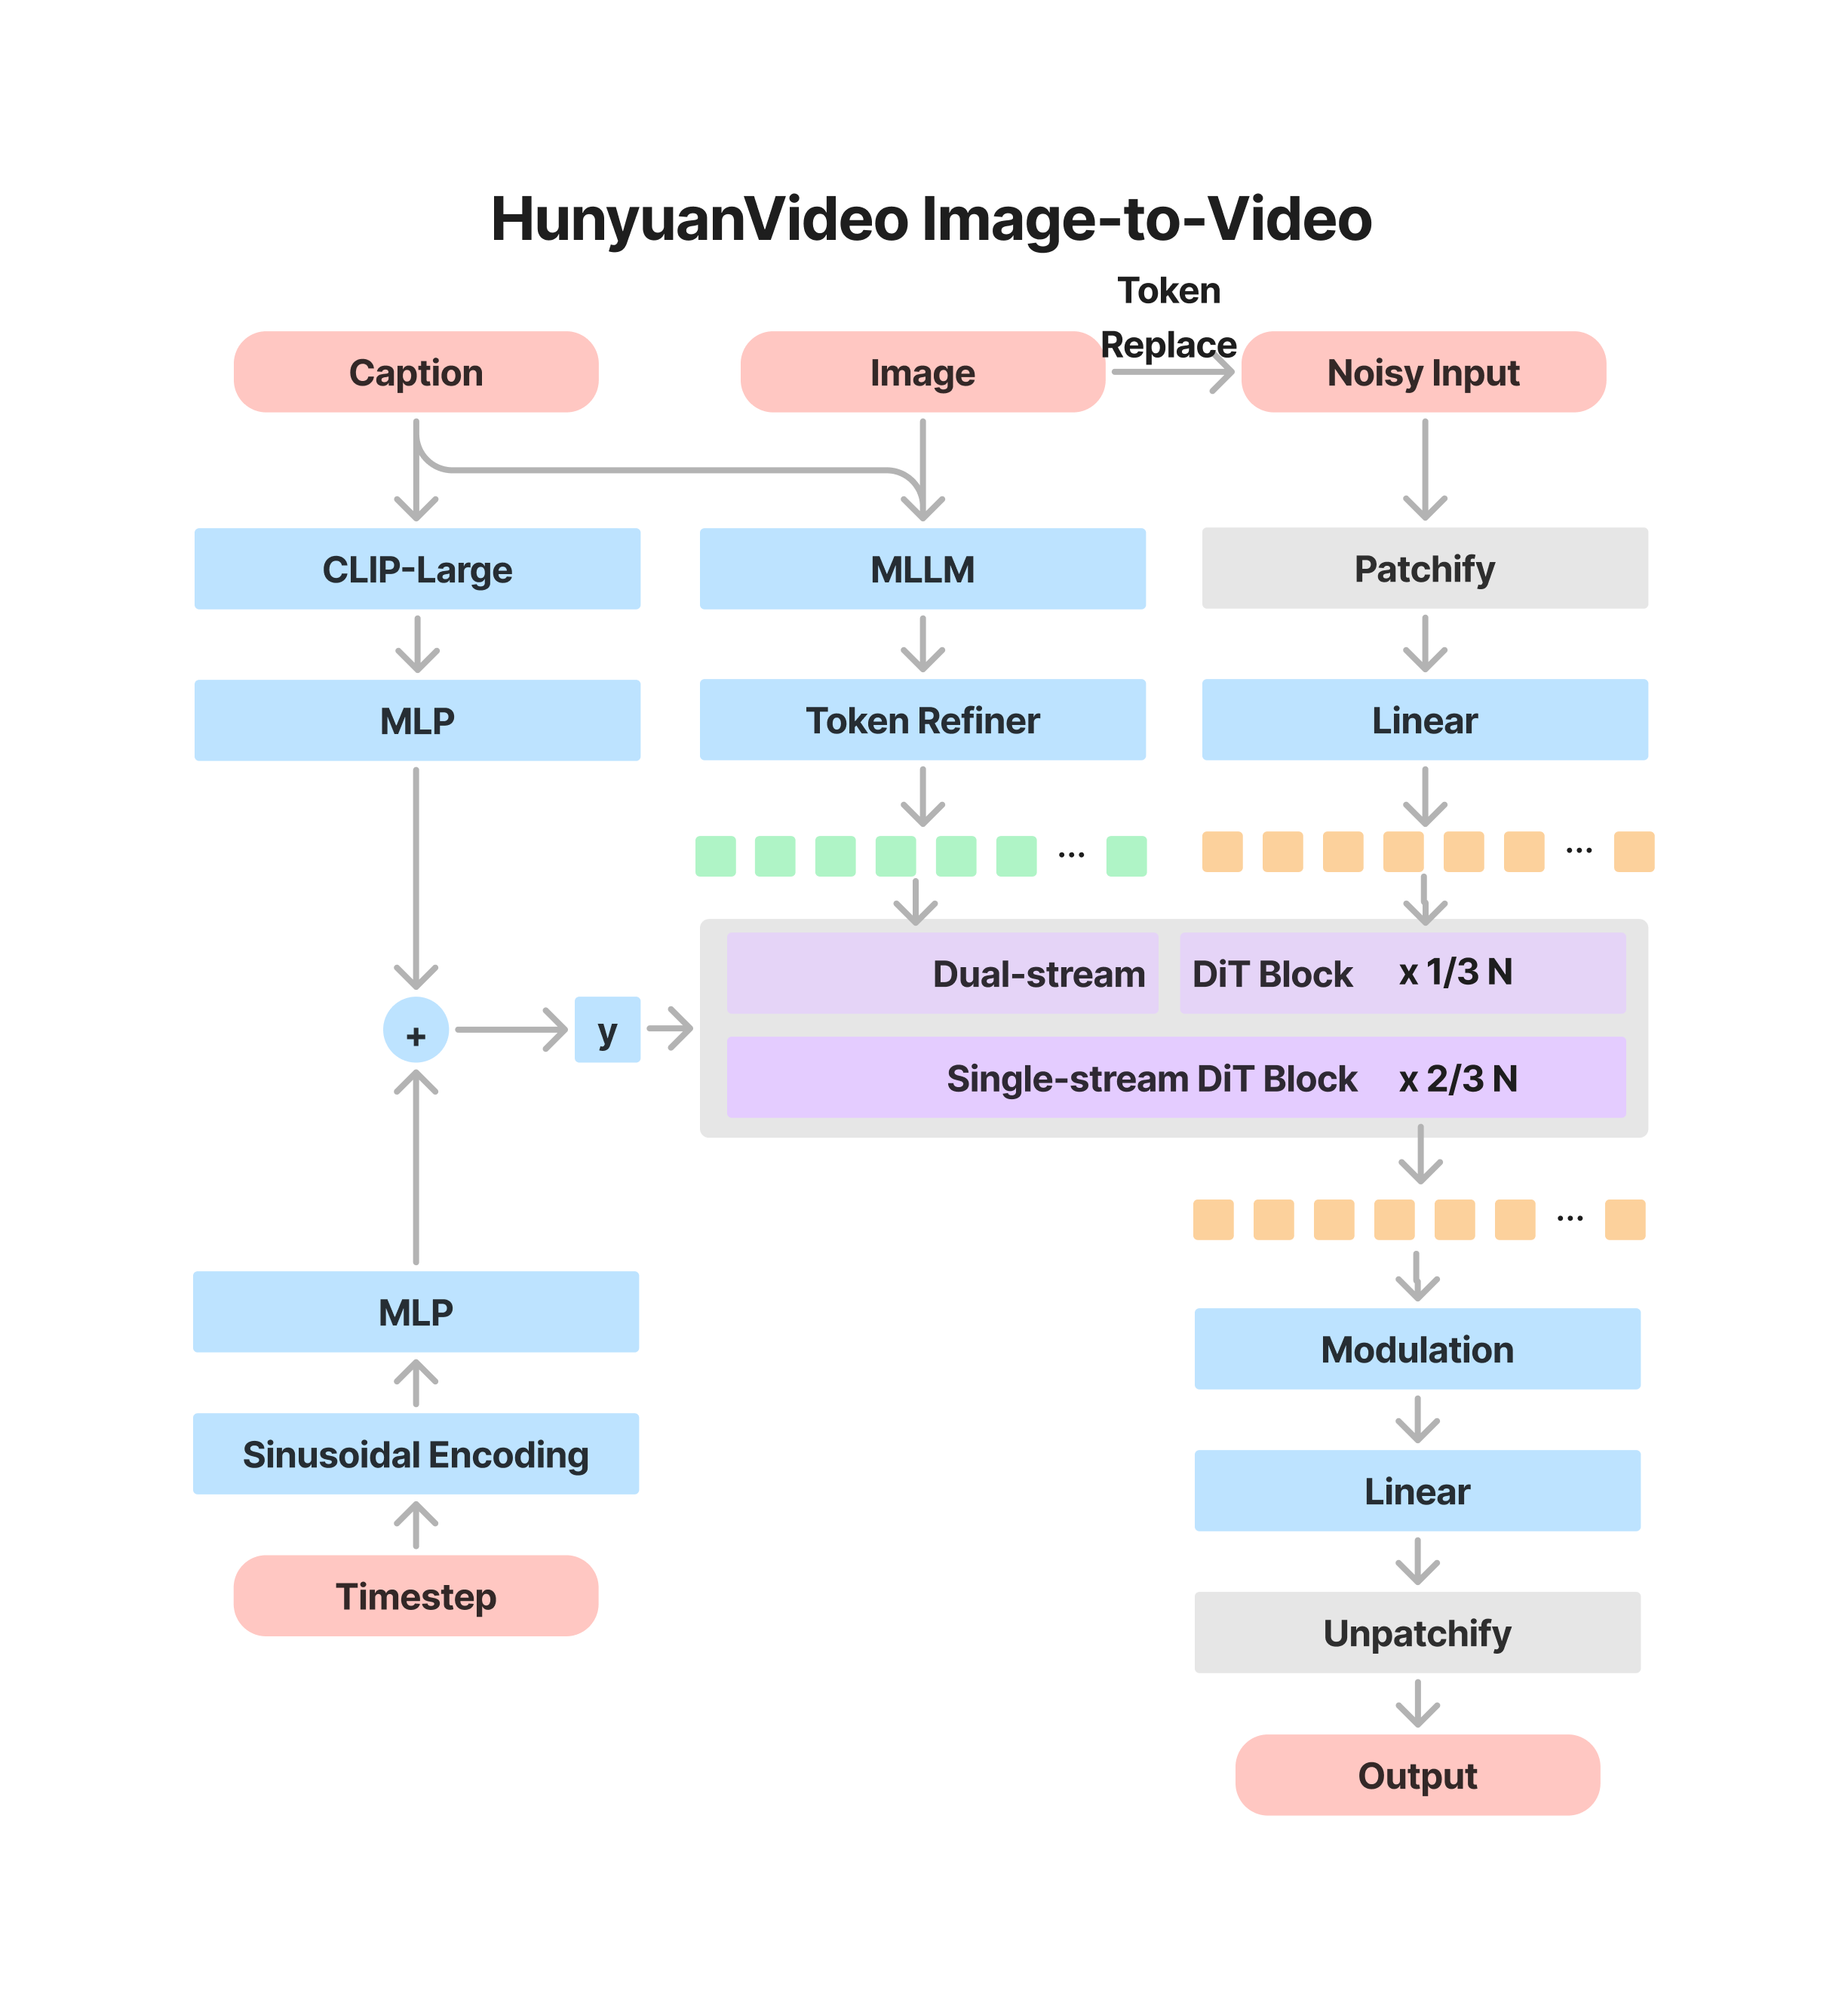
同一套栈也可以跑 HunyuanVideo-I2V:用 token replace 重建并写入参考图,将 MLLM 语义图像 token 与视频潜变量拼接后做全注意力计算。
构建运行命令
HunyuanVideoT2VPipelineworldfoundry.pipelines.hunyuan_video.pipeline_hunyuan_videointeractive-videoworldfoundry.pipelineworldfoundry-eval run \
hunyuanvideo-t2v \
--pipeline.task-profile interactive-video \
--json变体
- 状态Runner 一致性待确认
hunyuanvideo-t2vtext-to-video
Runtime profile
hunyuanvideo-t2vPipeline binding
hunyuanvideo-t2v - 状态Runner 一致性待确认
hunyuanvideo-i2vimage-to-video
Runtime profile
hunyuanvideo-i2vPipeline binding
hunyuanvideo-i2v
架构
HunyuanVideo 在因果 3D VAE 压缩后的时空潜空间上去噪。文本提示由大语言模型编码为条件;生成模型以高斯噪声和该条件为输入,输出隐变量,再由 3D VAE 解码器还原为图像或视频。
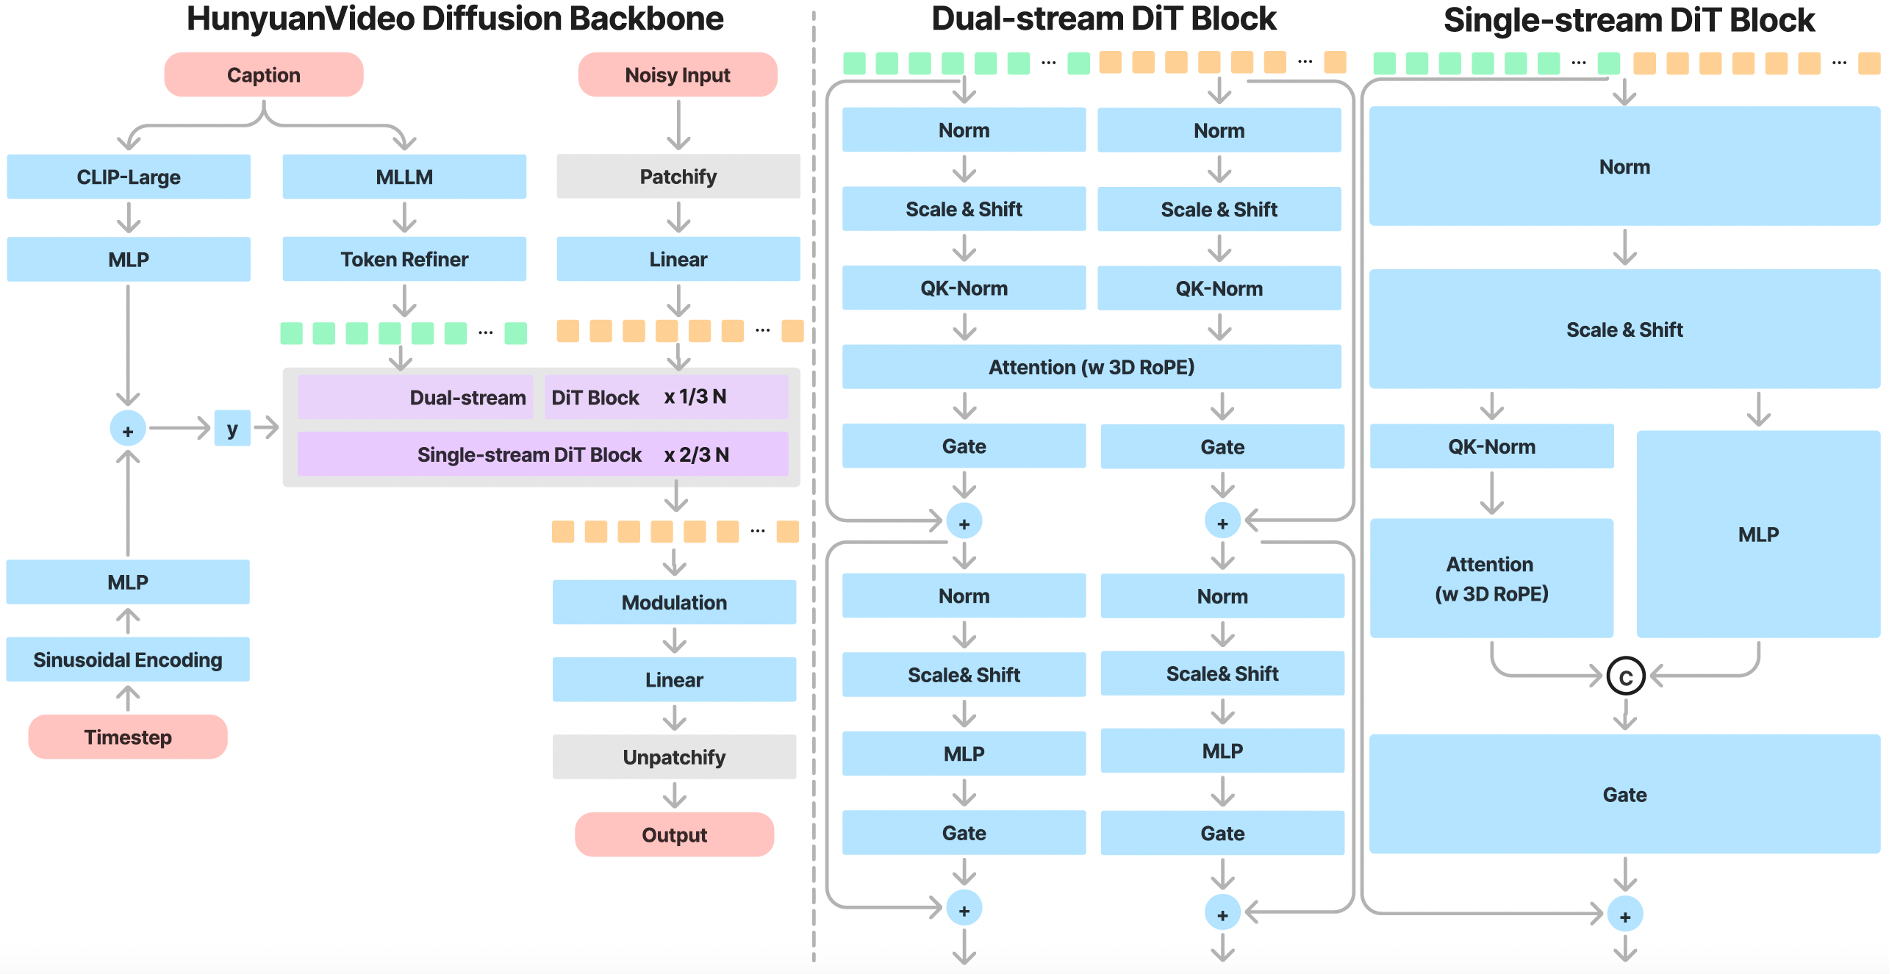
骨干是带 Full Attention 的 Transformer,采用「双流到单流」结构:视频与文本 token 先经独立 Block 学习各自的调制,再拼接后在后续 Block 中融合。
文本编码器
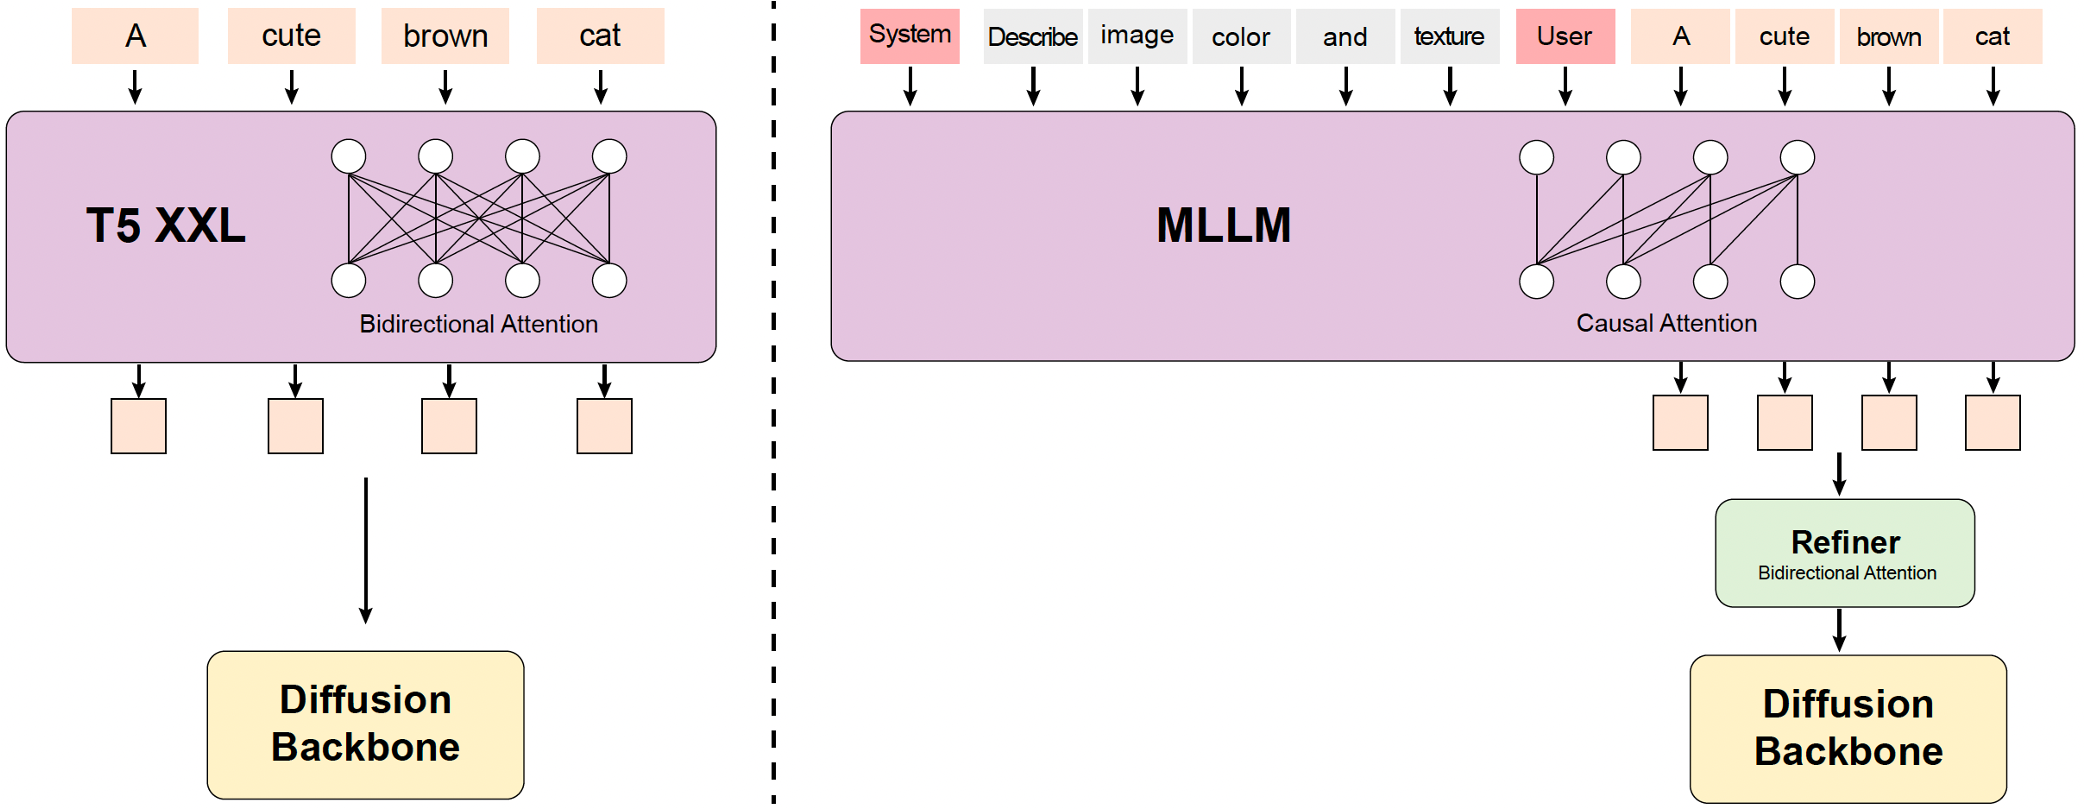
文本编码器是预训练的 Decoder-Only 多模态大语言模型,而不是 CLIP 或 T5-XXL。它可以跟随写在用户提示前的系统指令。由于 MLLM 使用因果注意力,官方额外加入双向 token 优化器以增强文本特征。
因果 3D VAE
CausalConv3D VAE 将像素空间视频与图像按时间 4 倍、空间 8 倍、通道 16 压缩,使扩散 Transformer 能在源分辨率和帧率下、于潜空间中运行。
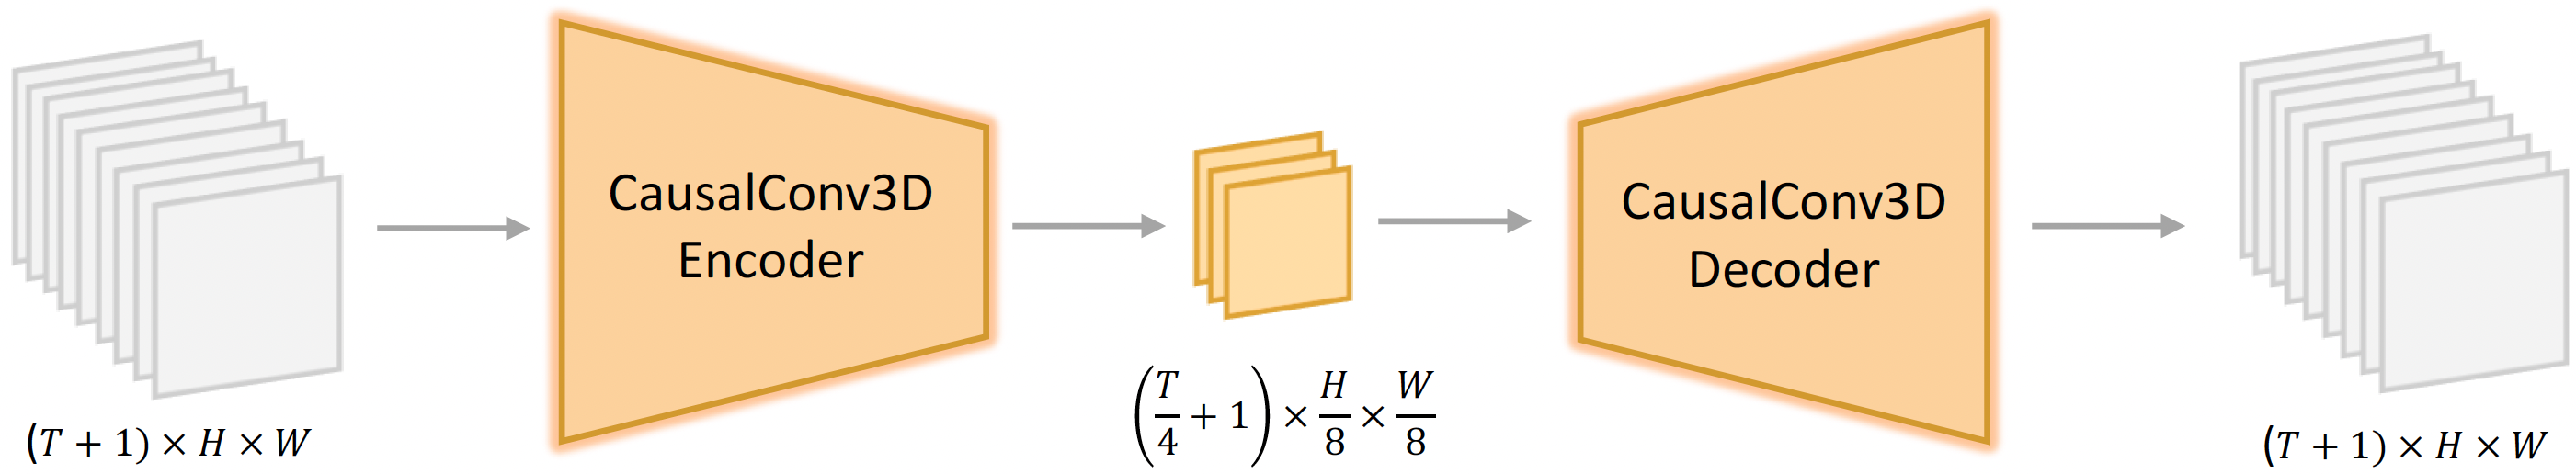
用户提示的风格和长度差异很大,因此用微调后的 Hunyuan-Large 做 Prompt 改写。正常模式更贴近用户意图;导演模式补充构图、光照和镜头运动,视觉质量更高,但有时会丢掉部分语义。
图生视频
HunyuanVideo-I2V 沿用上述结构,并用 token replace 写入参考图:MLLM 给出的语义图像 token 与视频潜变量拼接后,在图文两个模态上做全注意力计算。
推理
官方推理覆盖文生视频与图生视频,分辨率 540p 与 720p(推荐),129 帧,画幅 9:16、16:9、4:3、3:4 与 1:1。batch size 为 1 时,720×1280×129 峰值显存 60GB,544×960×129 为 45GB;I2V 720p 同样记为 60GB。官方在单张 80GB GPU 上测试,并建议用 80GB 以获得更好质量。I2V 若追求更稳,可打开 --i2v-stability 并将 flow-shift 设为 7.0;若追求更强动态,则关闭 stability、flow-shift 设为 17.0。FP8 T2V 权重大约节省 10GB 显存。
WorldFoundry 原生文生视频配方(HunyuanVideoT2VPipeline)默认为 720×1280、129 帧、50 步、24 fps、guidance 6.0。图生视频(HunyuanVideoI2VPipeline)沿用同一几何,除非你覆盖 height / width / frames。必填输入是 prompt;图生视频还需要参考 image;actions 是 seed。产物:hunyuanvideo-t2v.mp4 / hunyuanvideo-i2v.mp4。
在 WorldFoundry 中
文生视频与图生视频都是声明式的原生扩散配方,由共享 runner 组装,不用上游 CLI。启动 worldfoundry-eval run hunyuanvideo-t2v,或对应的 hunyuanvideo-i2v。权重是 tencent/HunyuanVideo 与 tencent/HunyuanVideo-I2V(卡片 license 为 other)。集成已记录;runner 与 demo 一致性仍为 pending,所以命令能跑不等于本工作区已有 checkpoint 驱动的 GPU 产物。使用统一环境 worldfoundry-unified-cu128,并在本地就位权重。官方 720p / 129 帧任务面向 80 GB 级 GPU;只有接受论文里的 540p / FP8 折中时,才往下规划。
最小评测
文生视频片段走 VBench 的 custom_input / aesthetic_quality,读 aesthetic_quality。runner 一致性仍为 pending;命令能启动不等于已验证 GPU 产物。



