
MMAudio
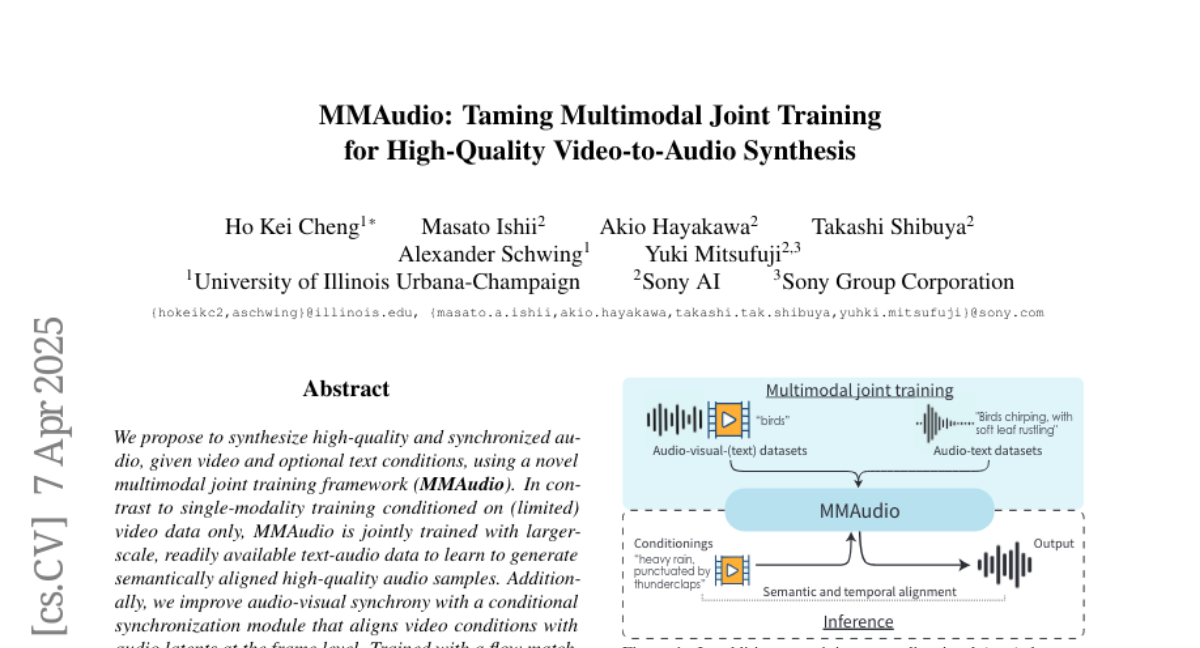
MMAudio(Sony AI / University of Illinois Urbana-Champaign):文生音频、视频生音频;Runner 一致性待确认。
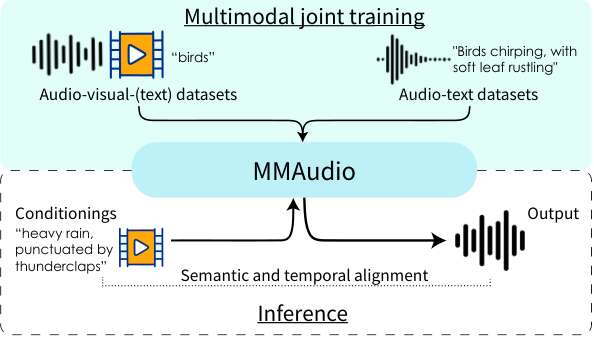
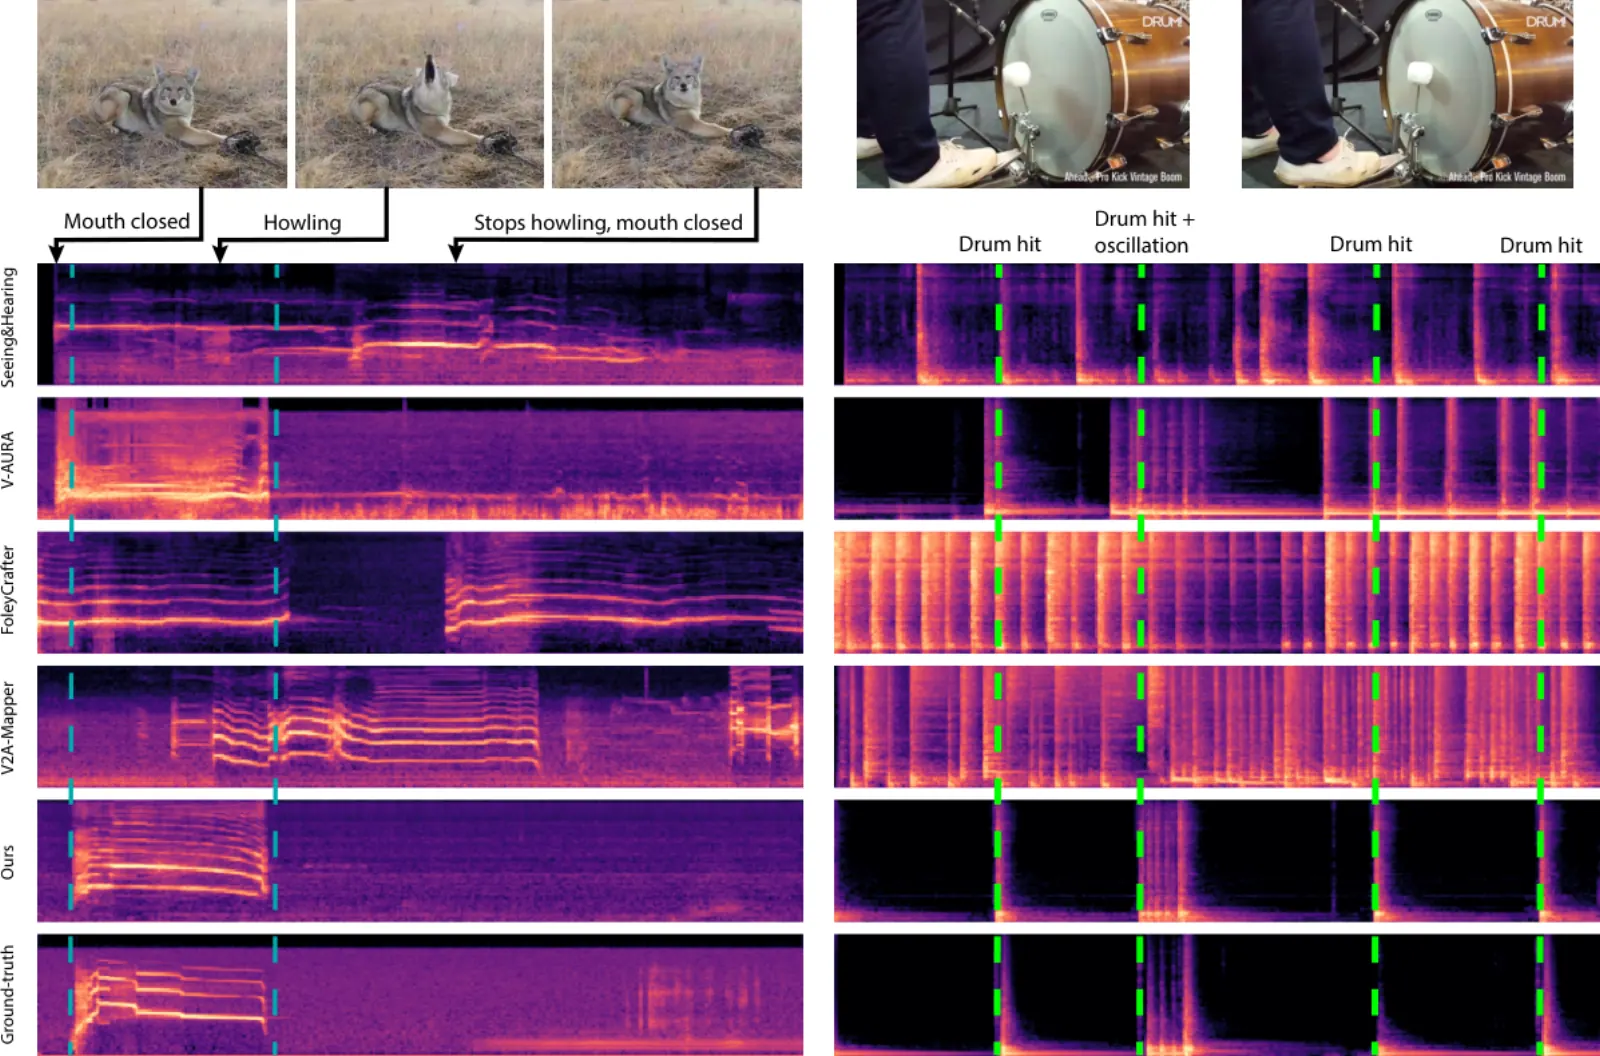
MMAudio 为无声视频生成配音:给定一段视频(可附文本提示词),它合成与画面语义和时间对齐的音频。在本 catalog 中它是为视频模型产物补配音的配套工具——产物类型是 generated_audio,而非视频。
记录论文为arXiv 2412.15322。
项目页:hkchengrex.github.io/MMAudio。代码:hkchengrex/MMAudio。
构建运行命令
MMAudioPipelineworldfoundry.pipelines.video_official.pipeline_official_videointeractive-videoworldfoundry.pipelineworldfoundry-eval run \
mmaudio \
--pipeline.task-profile interactive-video \
--json用来做什么
mmaudio 是记录的音频线。按记录输入写出音频时从这里起步。
MMAudio 是多模态联合训练的流匹配(flow-matching)模型,以视频帧与文本为条件生成音频(见其论文)。本仓库记录 prompt/video 输入契约与 generated_audio 产物;模型尺寸选项与内部细节仓库未记录。该模型由索尼 AI / 伊利诺伊大学厄巴纳-香槟分校发布。
catalog 记录的任务包括 文生音频、视频生音频、audio-generation。别名包括 hkchengrex/MMAudio。
运行时契约
可选 prompt、negative_prompt、input_path、frames、fps;产物 mmaudio.wav。
CLI task profile:interactive-video。绑定的 pipeline 类是 MMAudioPipeline。
系列状态:Runner 一致性待确认。
典型工作流:先用任一文生/图生视频条目出片,再把视频交给 MMAudio 生成配音。
Checkpoint 属于外部资产——权重缺失时会在运行时报告,而不会自动下载。
在 WorldFoundry 中运行
启动 worldfoundry-eval run mmaudio --pipeline.task-profile interactive-video 写出音频。上方命令构建器按已记录任务切换 --pipeline.task-profile,发出的仍是 worldfoundry-eval run。
运行环境是统一 profile worldfoundry-unified-cu128(Python 3.11,CUDA 12.8)。
记录的权重仓库包括 hkchengrex/MMAudio。准备环境并检查本地资产:bash scripts/inference/prepare_model_infer.sh mmaudio;下载缺失的公开权重时加 --download。
状态:Runner 一致性待确认。



