ModelScopeT2V
ModelScopeT2V(Alibaba (DAMO Academy / ModelScope)):文生视频;Runner 一致性待确认。
ModelScopeT2V 是阿里达摩院最早开源的文生视频扩散模型——那个带动了开源 T2V 生态的 1.7B 模型(本 catalog 中的 ZeroScope 就是它的微调版)。WorldFoundry 路径已完备,checkpoint 缺失会在运行时报告。它主要作为历史基线保留。
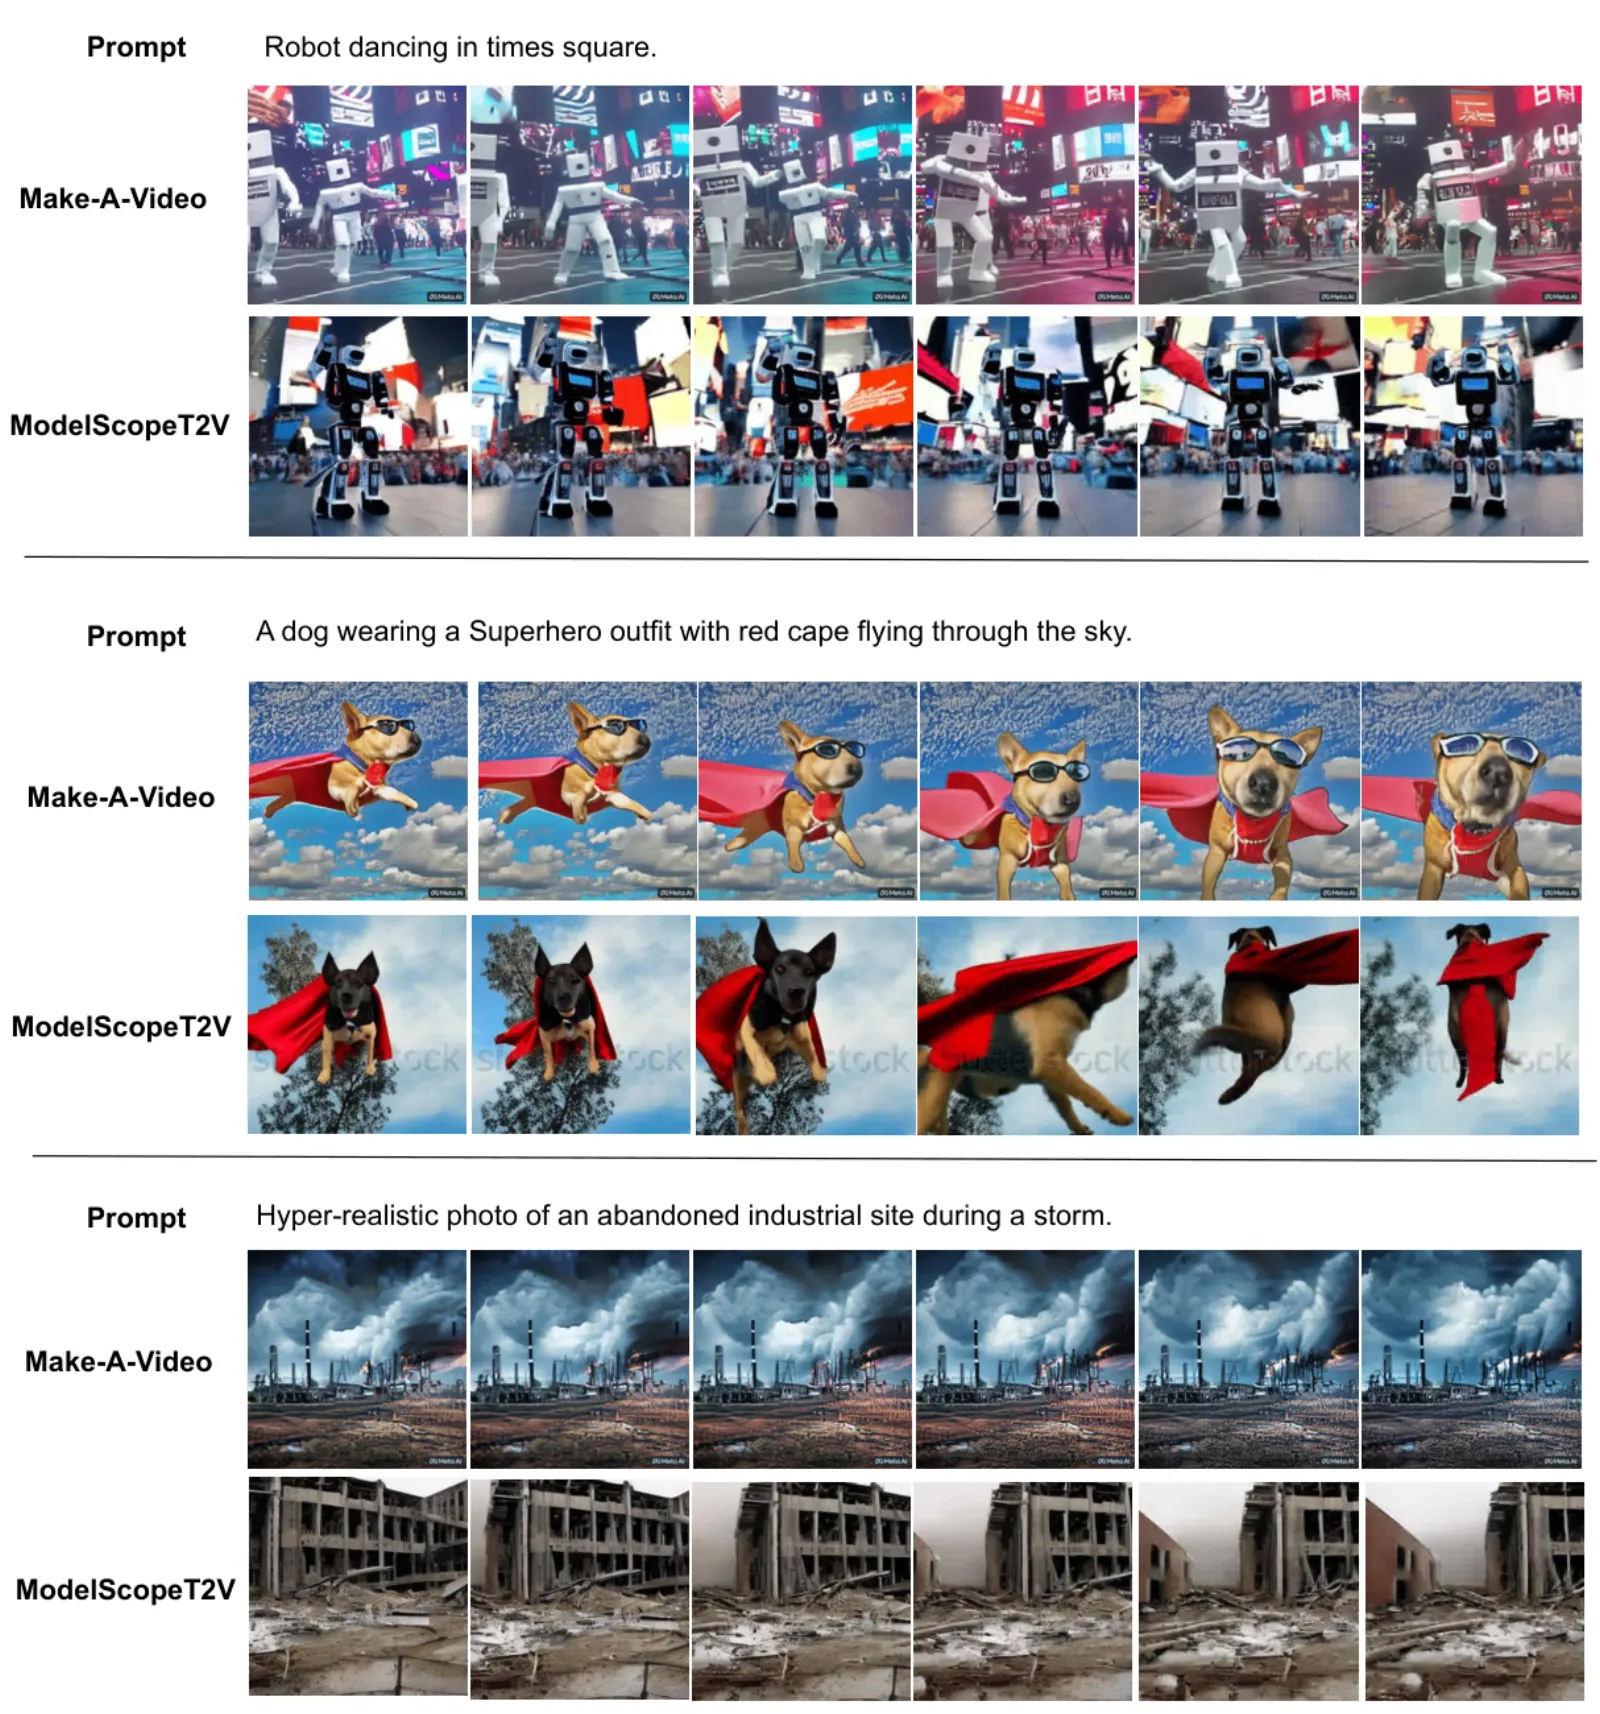
记录论文为arXiv 2308.06571。
项目页:modelscope.cn。代码:modelscope/modelscope。
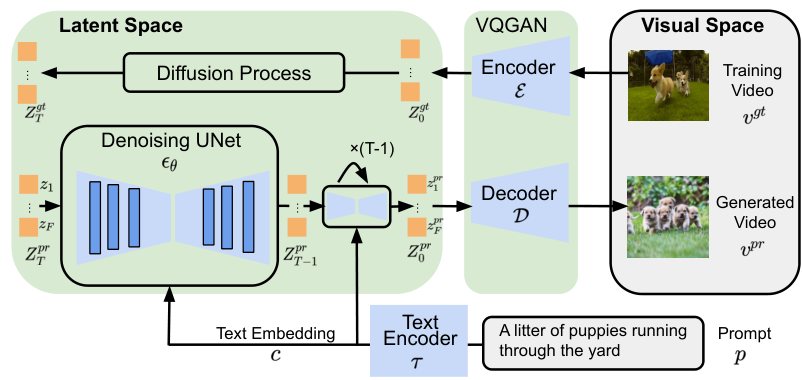
结构上它是 潜空间视频 U-Net:在文生图扩散骨干里插入时间注意力,让一句 prompt 变成一段短、低分辨率片段。这也是后来的 DiT 系列(Wan、CogVideoX、HunyuanVideo)在画质和时序上取代它的原因。Hugging Face 卡片是 ali-vilab/modelscope-damo-text-to-video-synthesis。记录的许可是 CC-BY-NC-4.0——manifest 明确要求不要当成无限制开源。
构建运行命令
ModelScopeT2VPipelineworldfoundry.pipelines.video_official.pipeline_official_videointeractive-videoworldfoundry.pipelineworldfoundry-eval run \
modelscope-t2v \
--pipeline.task-profile interactive-video \
--json用来做什么
modelscope-t2v 是记录的 prompt 到视频路由——不是图像编辑,也不是策略。只要任务是文生视频,从这里起步。
U-Net 潜空间视频扩散模型,在文生图基座中插入时序注意力层(见上游论文)。本仓库记录仅 prompt 的输入契约与 generated_video 产物。该模型由阿里巴巴(达摩院 / ModelScope)发布。
catalog 记录的任务包括 文生视频。模态上,它接受文本,输出视频。
记录的评测入口包括FETV(细粒度文生视频评测,适合老基线)。
复现 2023 年左右的开源文生视频基线:必填 prompt 进,经 ModelScopeT2VPipeline 写出 modelscope-t2v.mp4。已接线的控制是文本提示、fps 和 seed。用来对照后来的条目,或解释 ZeroScope 的父模型。研究级或生产级文生视频请用 DiT 卡片。这一代模型常用的细粒度套件是 FETV。
运行时契约
可选 prompt、negative_prompt、frames、fps、height;产物 modelscope-t2v.mp4。
CLI task profile:interactive-video。绑定的 pipeline 类是 ModelScopeT2VPipeline。
系列状态:Runner 一致性待确认。
HF cardData 记录其许可为非商用——manifest 明确要求不要当作无限制开源使用。 仅建议用于研究对比;生产级文生视频请用基于 DiT 的条目。
Checkpoint license is non-commercial per HF cardData; do not treat as unrestricted open source.
在 WorldFoundry 中运行
启动 worldfoundry-eval run modelscope-t2v --pipeline.task-profile interactive-video 采样视频。上方命令构建器按已记录任务切换 --pipeline.task-profile,发出的仍是 worldfoundry-eval run。
运行环境是统一 profile worldfoundry-unified-cu128(Python 3.11,CUDA 12.8)。
记录的权重仓库包括 ali-vilab/modelscope-damo-text-to-video-synthesis、ali-vilab/modelscope-damo-text-to-video-synthesis。准备环境并检查本地资产:bash scripts/inference/prepare_model_infer.sh modelscope-t2v;下载缺失的公开权重时加 --download。
记录 license 为 cc-by-nc-4.0;状态:Runner 一致性待确认。
路径已集成在 worldfoundry-unified-cu128。启动 worldfoundry-eval run modelscope-t2v。缺失权重会在运行时报告。没有 runner-parity 证据。启动前就位 ali-vilab/modelscope-damo-text-to-video-synthesis——不要用名字相近的 model-scope/text-to-video-synthesis,那不是本条目选定的 checkpoint。



