Qwen2.5-Omni
阿里通义千问的全模态 7B:文本、图像、音频、视频进。WorldFoundry 记录的是文本响应路径——prompt 加可选图像或视频,JSON 出。
Qwen2.5-Omni 是阿里通义千问的端到端全模态模型。官方论文是 Qwen2.5-Omni Technical Report(arXiv 2503.20215)。代码与模型卡见 QwenLM/Qwen2.5-Omni 与 Qwen/Qwen2.5-Omni-7B。在本 catalog 中它是理解 / 推理条目——不是视频生成器——产物为 model_response。别名 qwen2p5-omni、qwen2p5_omni、Qwen/Qwen2.5-Omni-7B 解析到本页。
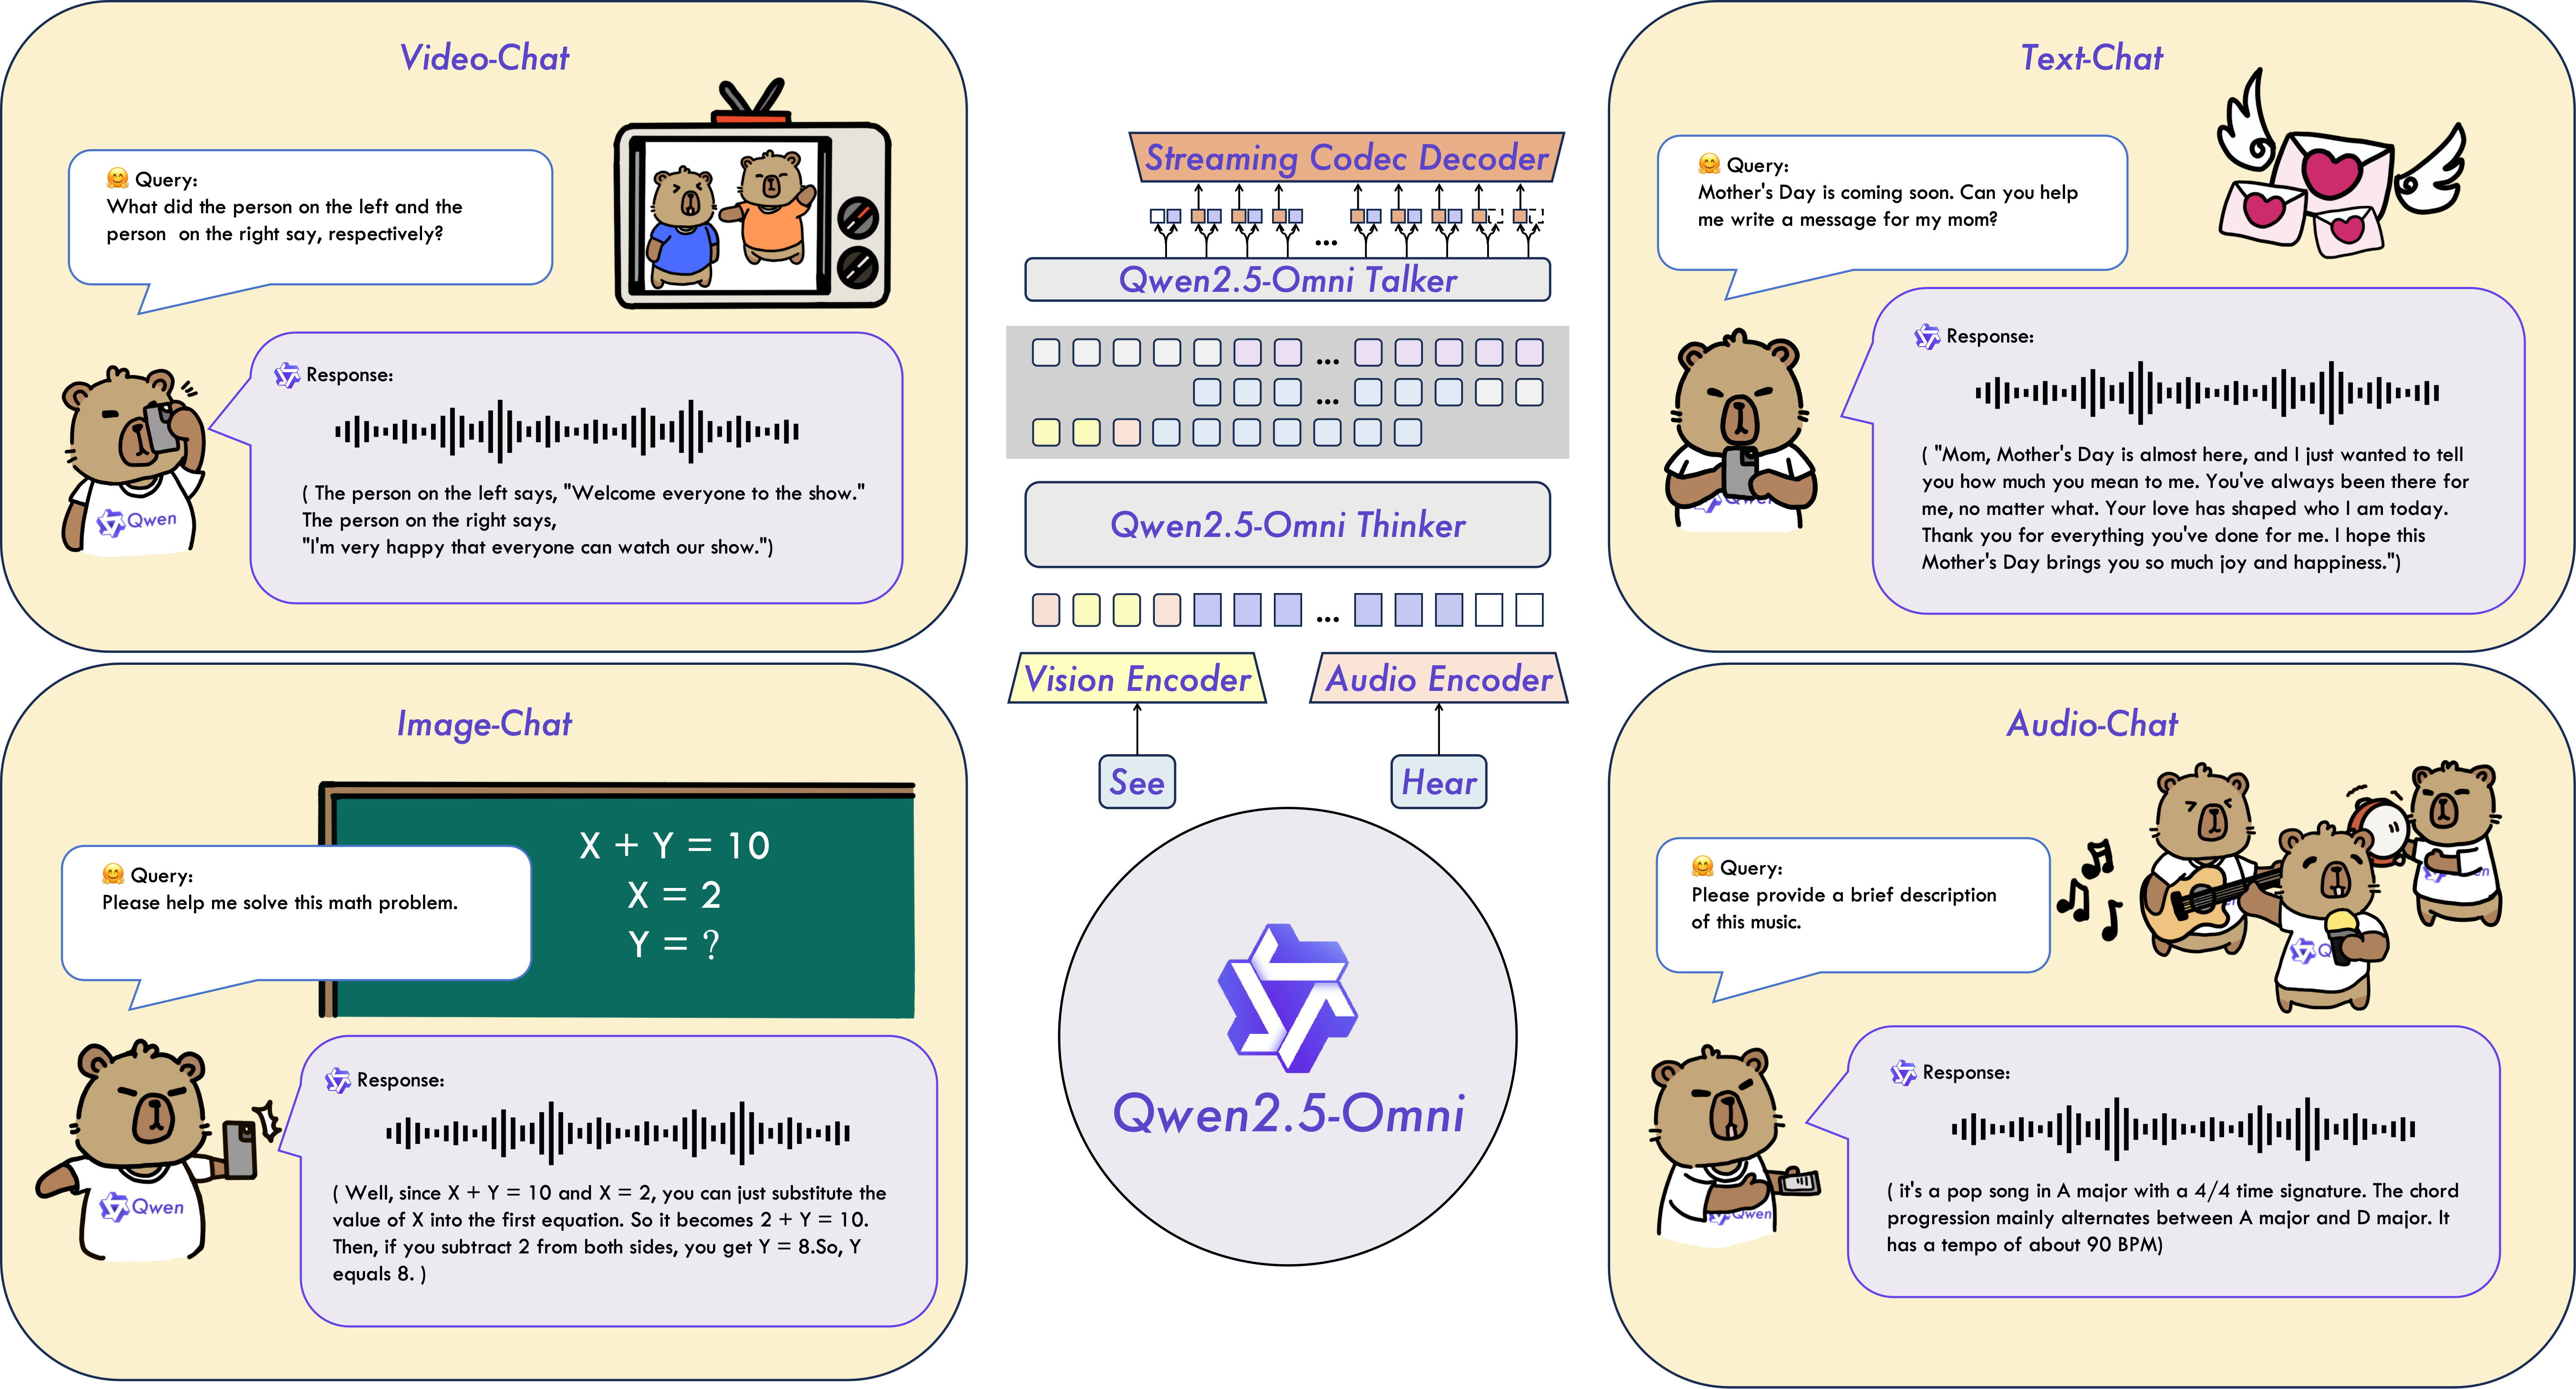
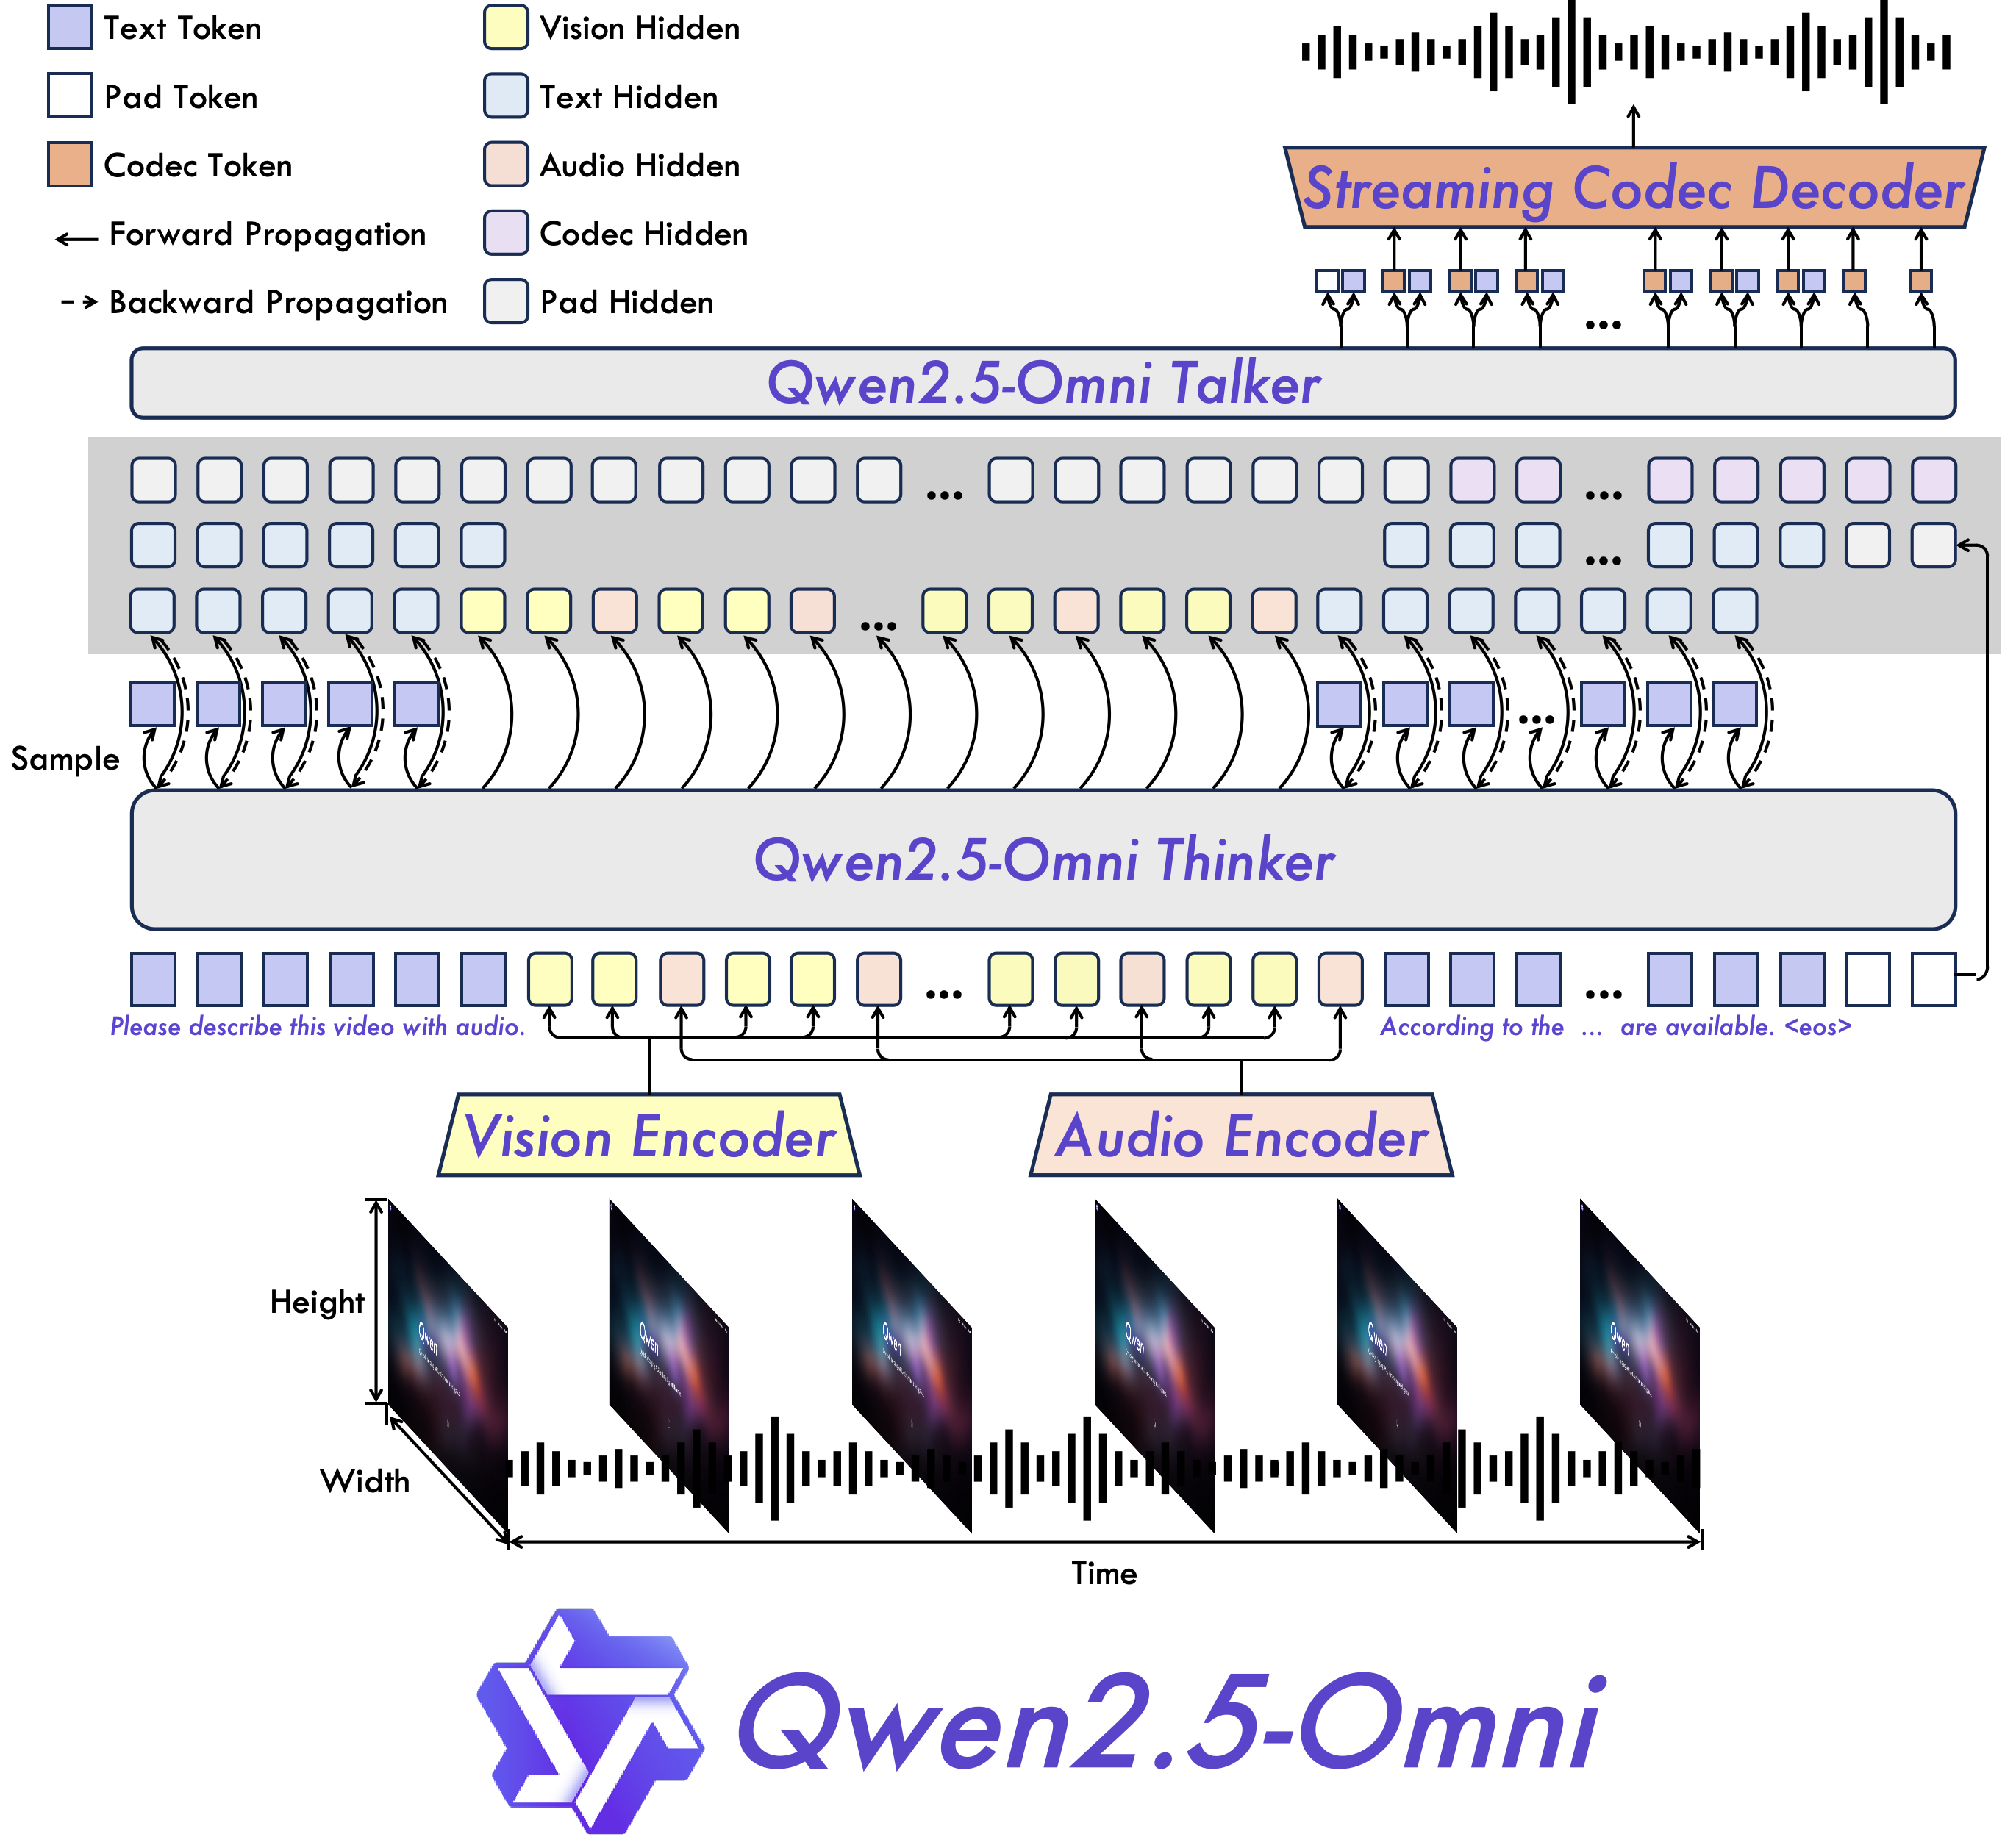
论文描述的是 Thinker-Talker 栈,并用 TMRoPE(时间对齐的多模态 RoPE)让音频与视频共用同一时钟。官方能力是感知文本、图像、音频、视频,并可同时流式输出文本与语音。TMRoPE 里音频帧按 40 ms 一个 temporal id 对齐。WorldFoundry 只接通文本响应路径:必填 prompt,可选 image / video,产物 qwen2.5-omni.json。记录的权重是 7B 版本。本 catalog 未记录许可证;Hugging Face 卡片元数据为 other——生产使用前请自行核对。
构建运行命令
Qwen25OmniPipelineworldfoundry.pipelines.video_official.pipeline_official_videoworldfoundry.pipelineworldfoundry-eval run \
qwen2.5-omni \
--pipeline.task-profile multimodal-reasoning \
--json用来做什么
为其他 catalog 条目生成的静帧或片段做描述、追问或质检。记录的任务 profile 是 multimodal-reasoning(默认)、audio-reasoning、image-question-answering、video-question-answering。四条线共用同一输入契约,经 Qwen25OmniPipeline 写出 qwen2.5-omni.json。
先就位 Qwen/Qwen2.5-Omni-7B。缺失权重在运行时报告,runner 不会自动下载。7B 规模按单张现代 GPU 设计。
audio-reasoning 只是 catalog 任务名。记录的 WorldFoundry 字段仍没有 audio 输入——不要把本页当成已验证的语音进 / 语音出配方。
运行时契约
后端是官方 Hugging Face Transformers 运行时(official_hf_transformers_runtime)。加载方式为 from_pretrained。状态:Runner 一致性待确认——本工作区尚未完成带 checkpoint 的 GPU 产物验证。Talker / 流式语音解码不在记录路径里。
在 WorldFoundry 中运行
在统一环境 worldfoundry-unified-cu128(Python 3.11,CUDA 12.8)里运行 worldfoundry-eval run qwen2.5-omni --pipeline.task-profile multimodal-reasoning。准备 / 检查可用 bash scripts/inference/prepare_model_infer.sh qwen2.5-omni 与 worldfoundry-eval zoo model-show --model-id qwen2.5-omni。



