LIBERO
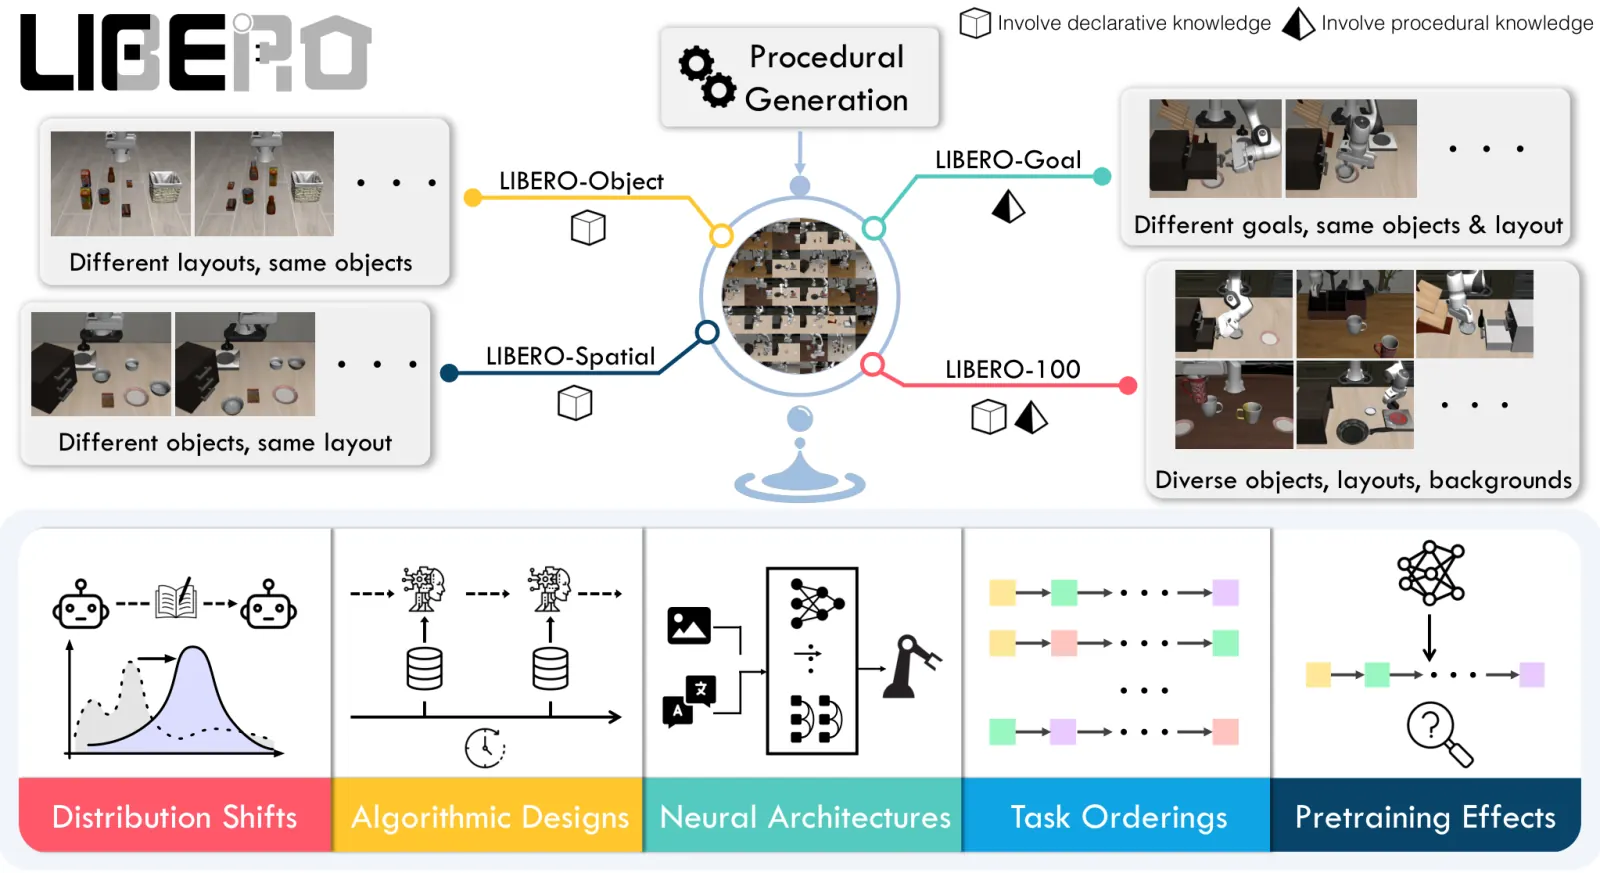
LIBERO(NeurIPS 2023 Datasets & Benchmarks)是德州大学奥斯汀分校的终身操作评测,联合清华与 Sony AI。Franka 在 robosuite / MuJoCo 桌面上,必须跨任务迁移陈述性与程序性知识。四个官方套件把「迁了什么」拆开:
- LIBERO-Spatial — 物体相同,空间关系 / 布局不同。
- LIBERO-Object — 技能相同,物体身份不同。
- LIBERO-Goal — 场景相同,目标语言不同。
- LIBERO-100 — LIBERO-10 短任务加 LIBERO-90 更长时程的混合。
它几乎成了 VLA 的默认成绩单。论文是 LIBERO: Benchmarking Knowledge Transfer for Lifelong Robot Learning。项目:libero-project.github.io。代码:Lifelong-Robot-Learning/LIBERO(MIT)。
WorldFoundry 支持两条路径。官方 eval_result 树(或结构化导出)走 worldfoundry.evaluation.tasks.embodied.normalizer。闭环执行经 worldfoundry-eval embodied run 接线,需要上游模拟器、套件资产,以及官方脚本期望的策略。数据集快照 yifengzhu-hf/LIBERO-datasets 与 lerobot/libero 作为就位资产跟踪。Being-H0.5 等模型有 LIBERO 专家 checkpoint——那是模型卡片事实,不是 Hub 的 leaderboard 行。
评测维度
- LIBERO-Spatial类型套件
桌面布局上的空间关系迁移。
- LIBERO-Object类型套件
操作任务中的物体身份迁移。
- LIBERO-Goal类型套件
目标描述迁移。
- LIBERO-100类型套件
LIBERO-10 与 LIBERO-90 组成的长程混合套件。
数据组成
- 规模
四个终身学习套件,基于 robosuite/MuJoCo 的 Franka 桌面:Spatial、Object、Goal,以及 LIBERO-100(LIBERO-10 + LIBERO-90)。官方演示在 yifengzhu-hf/LIBERO-datasets;LeRobot 转换版在 lerobot/libero。
- 来源
yifengzhu-hf/LIBERO-datasets · lerobot/libero · github.com
- 划分
libero_spatial · libero_object · libero_goal · libero_10 · libero_90
- 模态
language · vision · action · state
- 许可证
mit
- 说明
WorldFoundry 可以导入官方 eval_result 树,也可以接线闭环执行;套件选择与随机种子必须匹配上游协议才可比较。
指标
指标
- 方向越高越好
success_rate评测 rollout 上的主成功率(逐 episode 成功比例)。
主指标Success Rate
- 方向越高越好
task_success按任务聚合的成功率。
- 方向越高越好
episode_success逐 episode 成功指示的聚合值。
- 方向越高越好
action_accuracy相对参考动作的离线动作预测准确率。
Leaderboard
论文报告结果(非实时榜;不是 WorldFoundry 跑分)。 原论文终身学习基线,不是后续 VLA 榜。 LIBERO: Benchmarking Knowledge Transfer for Lifelong Robot Learning (2023).
| 模型 | LIBERO-Spatial AUC(ResNet-T) |
|---|---|
| PackNet | 0.63 |
| Experience Replay | 0.56 |
| Sequential fine-tuning | 0.20 |
| EWC | 0.06 |
如何运行
导入官方结果树(不跑模拟器):
worldfoundry-eval zoo benchmark-run \
  --benchmark-id libero \
  --mode official-validation \
  --official-results-path <official_results.json> \
  --output-dir tmp/libero/official-validation \
  --json
闭环执行需要 WORLDFOUNDRY_LIBERO_ROOT(可选,覆盖 runtime/仓库根)、套件资产和匹配的策略。省略 --official-results-path 时,默认导入路径是 WORLDFOUNDRY_LIBERO_RESULTS_PATH。共享资产栈:libero_source_assets、libero_dataset_assets。
仓内指针:
worldfoundry/data/benchmarks/tasks/external/libero.yaml
cache/worldfoundry/data/hfd_datasets/yifengzhu-hf__LIBERO-datasets
cache/worldfoundry/data/hfd_datasets/lerobot__libero
cache/vla_va_wam/repos/Lifelong-Robot-Learning--LIBERO
--output-dir 下包括 scorecard.json(主键 success_rate)、run_manifest.json、results.jsonl、metrics/summary.json。