
VMem
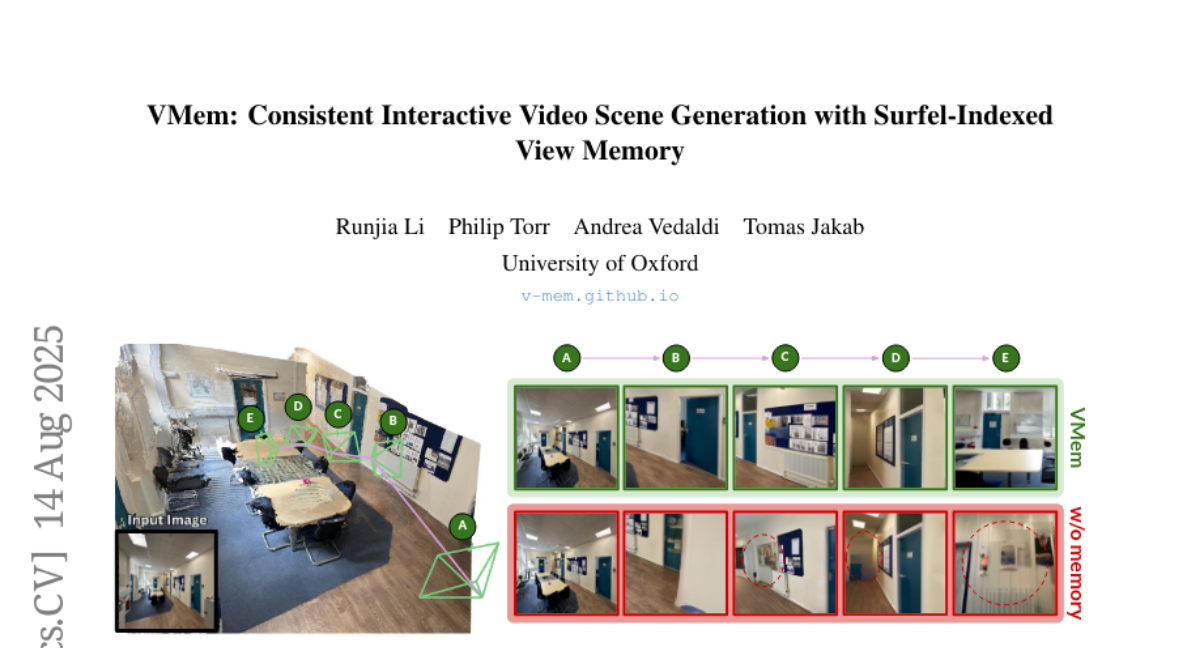
VMem(University of Oxford):视频生成、memory;已验证。
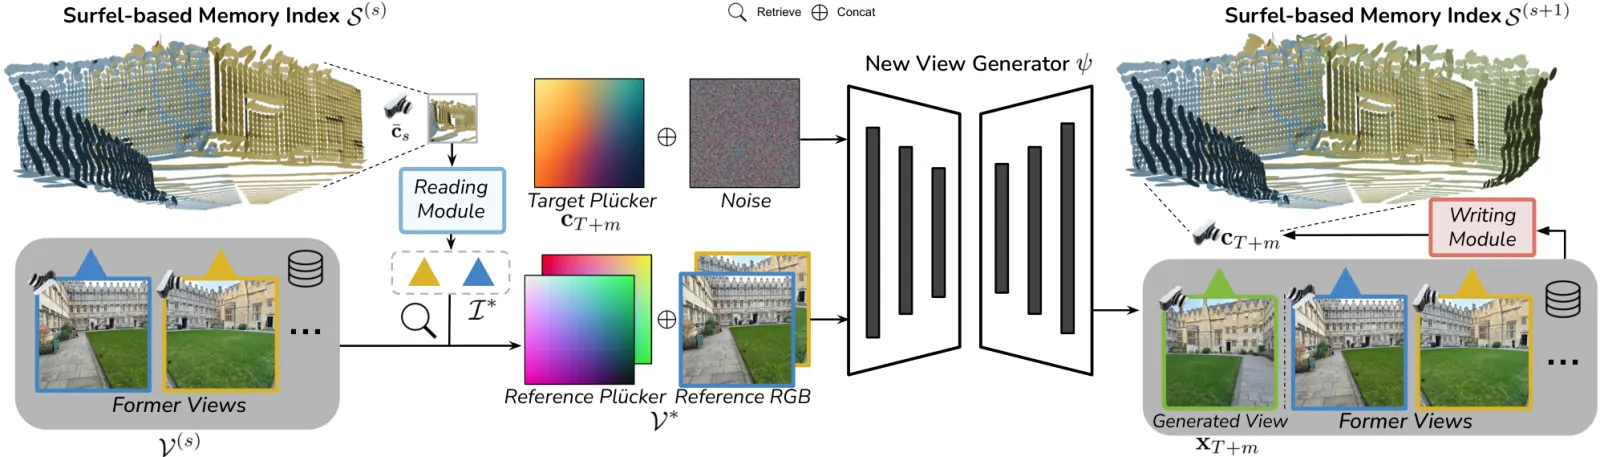
VMem 是带「面元索引视图记忆」的交互式视频场景生成模型:当你在场景中游走时,它记住哪些表面曾从哪些视角被看到,使新视角与历史保持一致。集成与 runner 状态均为 verified——Studio/API 视觉验证使用树内运行时与就位的 VMem、CUT3R checkpoint,复现了官方导航 demo。
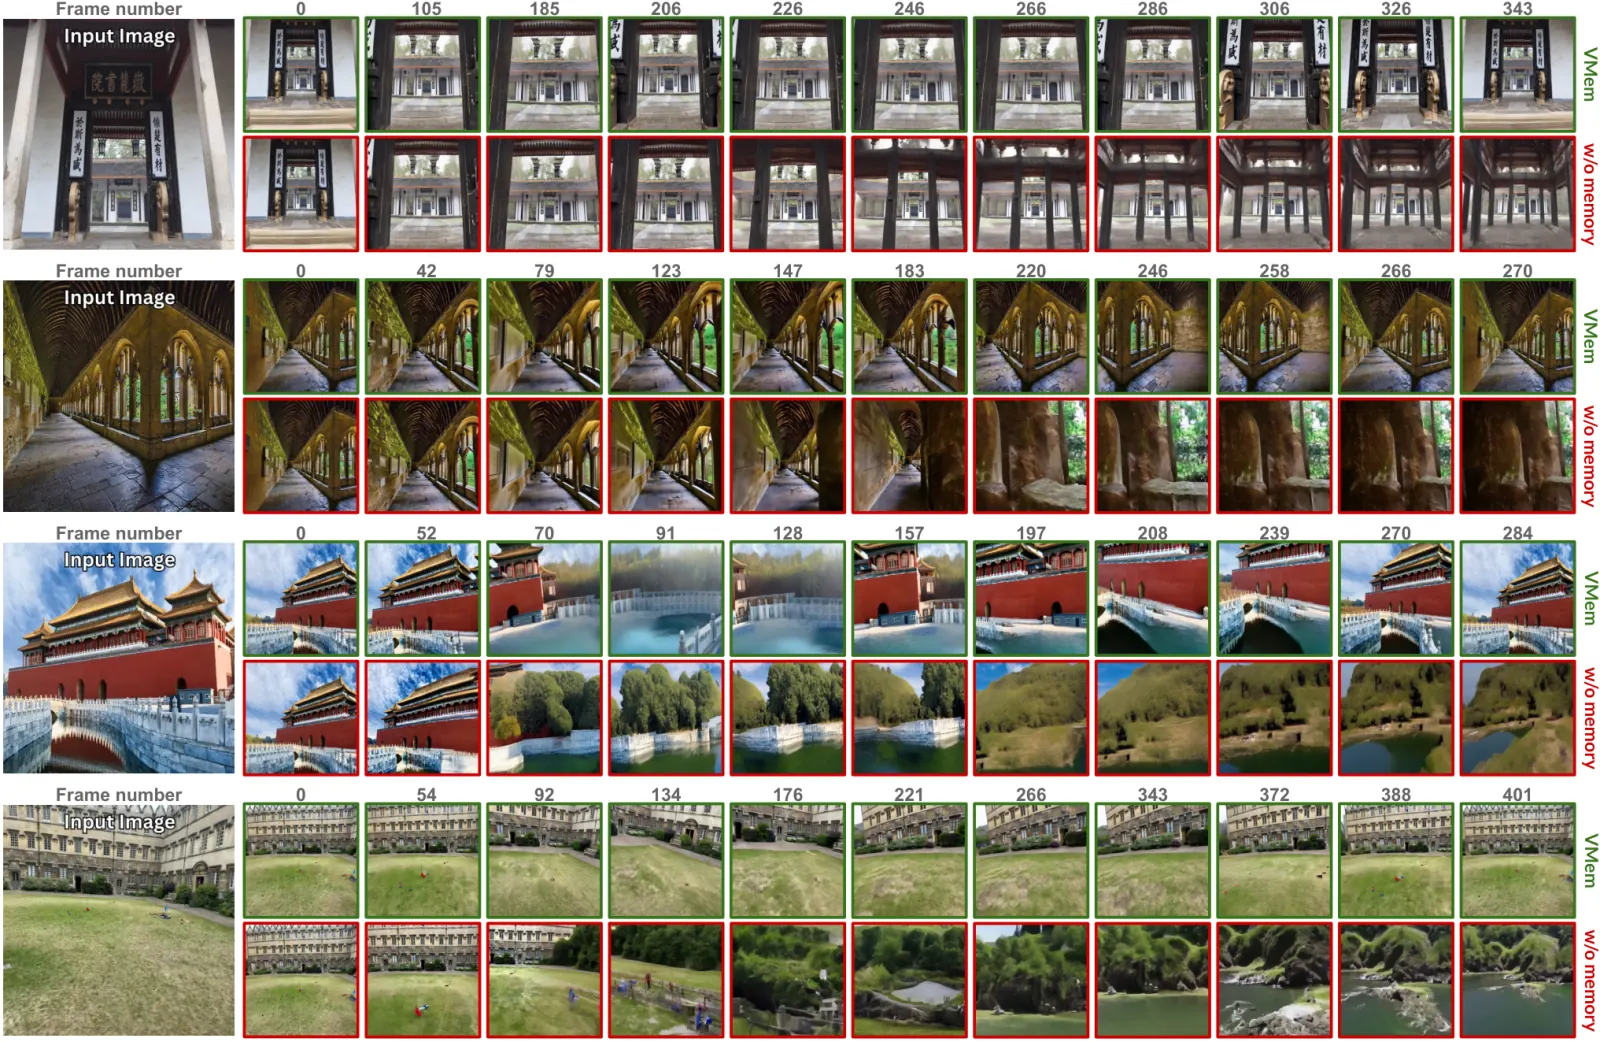
记录论文为VMem: Consistent Interactive Video Scene Generation with Surfel-Indexed View Memory(ICCV 2025 highlight, 2025)。
项目页:v-mem.github.io。代码:runjiali-rl/vmem。
构建运行命令
VMemPipelineworldfoundry.pipelines.vmem.pipeline_vmeminteractive-videoworldfoundry.pipelineworldfoundry-eval run \
vmem \
--pipeline.task-profile interactive-video \
--json用来做什么
用 vmem 做 catalog 世界模型推理。需要动作条件未来帧、而不是独立片段生成器时选它。
VMem 以面元(surfel)索引历史视图,检索相关视图作为下一视角生成的条件(见论文 arXiv 2506.18903)。该路径以 CUT3R 为几何主干;两组 checkpoint 均需就位。该模型由牛津大学发布。
catalog 记录的任务包括 视频生成、memory、stream、交互式世界模型。输出模态为视频。
记录的评测入口包括WorldScore(评估可相机游走的生成场景)。
运行时契约
可选 prompt、input_path、interactions、reset_state;产物 vmem.mp4。
CLI task profile:interactive-video。绑定的 pipeline 类是 VMemPipeline。
系列状态:已验证。
video 类别中少数完整验证过的交互式路径之一——树内 Studio/API 路径已于 2026-06-27 产出并通过视觉验证官方风格导航 demo。 输入覆盖 prompt/image/video/actions;输出为 generated_video 产物。
需要同时在本地就位 VMem 与 CUT3R checkpoint。
在 WorldFoundry 中运行
catalog 启动命令是 worldfoundry-eval run vmem --pipeline.task-profile interactive-video。上方命令构建器按已记录任务切换 --pipeline.task-profile,发出的仍是 worldfoundry-eval run。
运行环境是统一 profile worldfoundry-unified-cu128(Python 3.11,CUDA 12.8)。
记录的权重仓库包括 liguang0115/vmem、liguang0115/cut3r、SagiPolaczek/stable-diffusion-2-1-base 等。准备环境并检查本地资产:bash scripts/inference/prepare_model_infer.sh vmem;下载缺失的公开权重时加 --download。
状态:已验证。



