Action Chunking Transformer
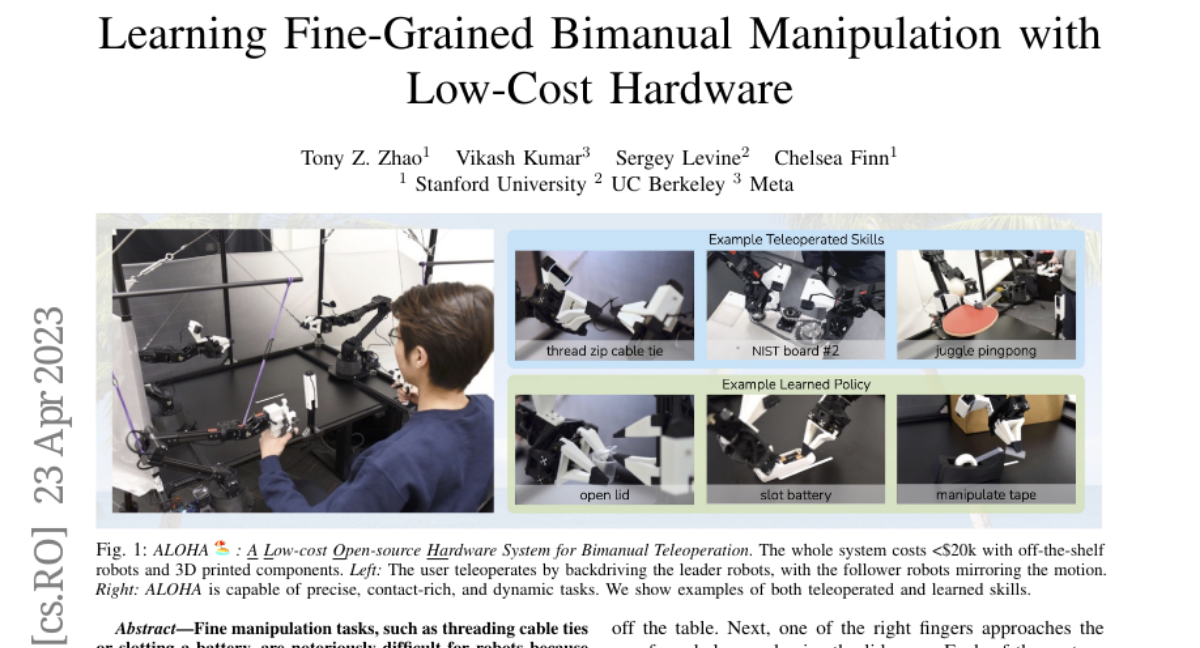
ALOHA 的 ACT:DETR-VAE 一次输出 50 步双臂动作块;WorldFoundry 树内推理,不附带 checkpoint。
ACT(Action Chunking Transformer)是 ALOHA 的模仿策略:不逐步给一个关节目标,而是一次输出短视野的未来动作,让控制更平滑。测试时丢掉 CVAE 编码器,风格隐变量取先验均值(零)。官方论文是 Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware(arXiv 2304.13705)。项目页:tonyzhaozh.github.io/aloha。代码在 tonyzhaozh/act。
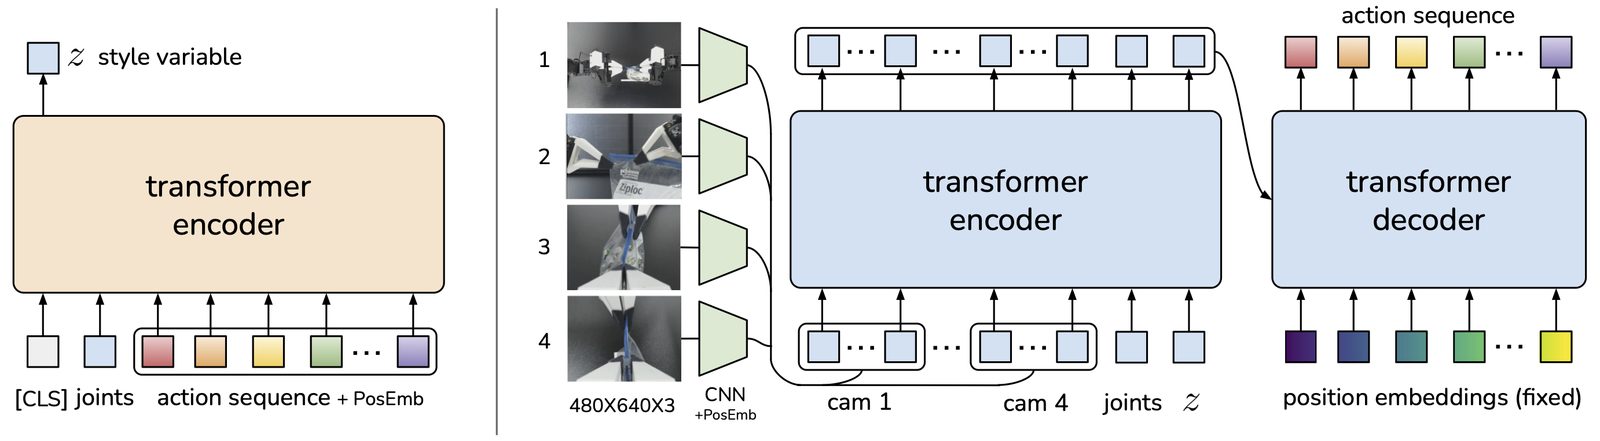
WorldFoundry 在 worldfoundry/synthesis/action_generation/act 下保留完整推理栈——DETR-VAE、transformer 编解码器、ResNet-18 骨干、预处理与时间聚合。没有 catalog variant,也没有官方权重文件。checkpoint 驱动的 predict_action 已实现;它只卡在调用方就位的 policy_best.ckpt 与匹配的 dataset_stats.pkl。静态与 CPU 契约检查已通过。别名 action-chunking-transformer 指到这里。
构建运行命令
ACTPipelineworldfoundry.pipelines.component_pipelinesinteractive-videoworldfoundry.pipelineworldfoundry-eval run \
act \
--pipeline.task-profile interactive-video \
--json用来做什么
把 ACT 当固定本体的 动作分块 基线——不是开放词汇 VLA。记录的输入是 RGB(image)和 instruction;prompt 不用。pipeline 是 ACTPipeline;产物是 act_action_trace.json。本 catalog 里最自然的本地目标,是你自己训练或 stage 的 scripted sim transfer-cube 策略,再和留出示范对比。
在接入更大的语言条件栈之前,用这一页核对 runner 一致性、checkpoint staging 与分块契约。
运行时契约
树内默认(不是下载来的 checkpoint):
- 相机:
cam_head、cam_right_wrist、cam_left_wrist - 本体感知:
state_dim14(两条 7 自由度臂) chunk_size50,temporal_agg=true,骨干 ResNet-18- Transformer:4 层编码 / 7 层解码,hidden 512,8 头
论文里 ALOHA 硬件写的是四路 480×640、50 Hz,并讨论真机 90 步块。那是上游硬件,不是上面的 WorldFoundry 配置。动作是 action_chunk,外加本体 / 动作空间元数据。
权重放这里:
${WORLDFOUNDRY_CKPT_DIR}/embodied_action/act/sim_transfer_cube_scripted/policy_best.ckpt
旁边放匹配的 dataset_stats.pkl。PyTorch 以 weights_only=true 和严格键加载。统计文件用仅 NumPy 读取器——不执行上游 pickle。
在 WorldFoundry 中运行
独立环境 worldfoundry-act(Python 3.10,CUDA 11.8 或更新)。运行时不下载任何包或 checkpoint。就位后:
worldfoundry-eval run act本仓库未记录许可证。生产使用前请确认上游 ACT / ALOHA 条款。