RoboFlamingo
OpenFlamingo 加 LSTM 动作头;WorldFoundry 的 GPU 验证 predict 需要就位三套 checkpoint。
RoboFlamingo 把 OpenFlamingo 变成语言条件机器人策略:VLM 编码相机帧和任务指令,循环头输出连续控制(通常是 7 自由度 位姿加夹爪)。官方论文是 Vision-Language Foundation Models as Effective Robot Imitators(arXiv 2311.01378)。项目页:roboflamingo.github.io。代码在 RoboFlamingo/RoboFlamingo。
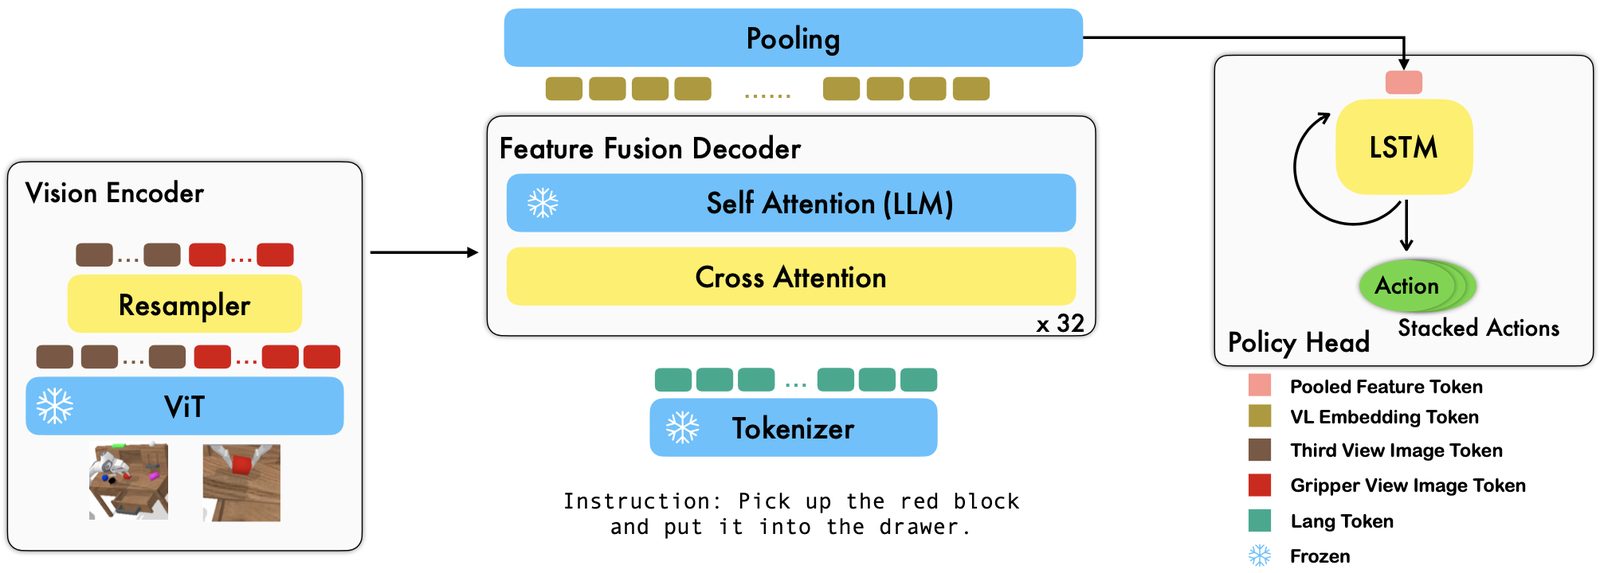
WorldFoundry 在 worldfoundry/synthesis/action_generation/roboflamingo 内置架构与推理源码。catalog 只有这一张卡片——没有额外 variant。公开 pipeline 用三套已就位栈通过了 CUDA action_trace 验证:发布的 CALVIN 策略、OpenFlamingo VLM、MPT 语言骨干。把它留在具身动作映射里,不要走视频生成 scorecard。别名 robo-flamingo 指到这里。
构建运行命令
RoboFlamingoPipelineworldfoundry.pipelines.component_pipelinesinteractive-videoworldfoundry.pipelineworldfoundry-eval run \
roboflamingo \
--pipeline.task-profile interactive-video \
--json用来做什么
面向 CALVIN 风格长时程套件上的语言条件操作。必填 image、instruction、prompt、video。RoboFlamingoPipeline 写出 roboflamingo_action_trace.json。
需要 GPU 就绪、且骨干 staging 路径明确的 OpenFlamingo 策略时用这一页——不是分块或扩散动作头。
运行时契约
树内架构默认:
- 视觉:ViT-L-14(OpenCLIP),语言:MPT-1B(配置里的
mpt_dolly_3b) window_size12,n_obs_steps2,融合post- 策略头:LSTM(
decoder_type/head_type都是lstm) - 开夹爪相机,关本体感知(
use_state=false),fp32
三套 checkpoint 目录都必须已在 ${WORLDFOUNDRY_HFD_ROOT} 下:
robovlms/RoboFlamingo→robovlms--RoboFlamingo(发布的 CALVIN 策略)openflamingo/OpenFlamingo-3B-vitl-mpt1b-langinstruct→openflamingo--OpenFlamingo-3B-vitl-mpt1b-langinstructanas-awadalla/mpt-1b-redpajama-200b-dolly→anas-awadalla--mpt-1b-redpajama-200b-dolly
视觉编码器文件还声明在 ${WORLDFOUNDRY_CKPT_DIR}/open_clip/ViT-L-14.pt。完整官方 CALVIN 评测仍需要 CALVIN 资产本身。
在 WorldFoundry 中运行
环境 profile 是 worldfoundry-unified-cu128。记录的 env YAML 是 Python 3.8、prepare-only 的 CUDA 标记;runner 仍在三套 checkpoint 就位后完成了 CUDA action_trace。就位后:
worldfoundry-eval run roboflamingo本仓库未记录许可证。生产使用前请确认 RoboFlamingo / OpenFlamingo / MPT 条款。